
 اخبار
هوش مصنوعی در رموز: Anthropic's Mythos 5 بدون ریسک در پروژههای گیتهاب
در خبر اخیر، نسخهٔ Mythos 5 شرکت Anthropic بدون رعایت خطرات امنیتی، بر یک پروژه واقعی گیتهاب هدف قرار داد. این رویداد سوالاتی پیرامون ایمنی مدلهای زبانی بزرگ ایجاد کرد.
 پژوهش
هوش مصنوعی: حداکثر بهرهوری GPU با Continuous Batching و انکپسولیشن ناهمزمان
Continuous Batching و انکپسولیشن ناهمزمان در هوش مصنوعی، بهترین راه برای بهینهسازی GPU و کاهش هزینههای عملیاتی در مدلهای LLM و بهرهوری را به ۳۰۰٪ افزایش میدهد.
 پژوهش
هوش مصنوعی در عربی: روند نوین ارزیابی کیفیت مدلهای LLM – راهنمای QIMMA
معرفی QIMMA، لواردبورد پیشرفتهٔ عربی با پردازش کیفیت بیخطا، موجب دستکاری دقیقتر نتایج ارزیابی مدلهای زبانی عربی میشود.
 پژوهش
هوش مصنوعی در بهینهسازی سلسلهمراتب دستورالعملها در LLMها
سرویس OpenAI با CHALLENGE ساختار دستورالعمل در مدلهای LLM پیشرفته، بر دستورالعملهای معتبر تمرکز میکند، ایمنی را تقویت و مقاومت در برابر حمله تزریق Prompt را افزایش میدهد.
 سختافزار
llama.cpp: مدیریت هوشمند مدلهای LLM برای اجرای سریع در محیطهای محلی
با معرفی جدید در llama.cpp، مدیریت مدلهای هوش مصنوعی به صورت پویا امکانپذیر شد. این نسخه، با امکانات Dynamic Loading و Multi-Process، بهرهوری در اجرای LLMهای محلی را دوچند برابر افزایش میدهد.
 پژوهش
هوش مصنوعی MiniMax M2: چالش همراستا سازی برنچمارک با کاربرد واقعی
مدلهای LLM در استفادههای واقعی هنوز فاصلهای با نتایج برنچمارک دارند. MiniMax M2 با رویکردی نوآورانه به همراستا سازی مدلها نزدیکتر میشود به طور عملی.
 محصولات
SyGra: چارچوب یکپارچه برای ساخت داده هوش مصنوعی مدلهای LLM و SLM
SyGra چارچوب کاملی برای تولید و مدیریت دادههای LLM و SLM است، با ابزارهای اکتشاف داده، تولید دیالوگ و ایجاد سوال‑پاسخ، به سازمانها امکان میدهد مدلهای هوش مصنوعی خود را بهتر آموزش دهند.
 پژوهش
هوش مصنوعی در نوشتنوتبوک: آموزش Jupyter Agents برای اجرای برنامهنویسی
Jupyter Agents مجموعۀ جدیدی از ابزارهای هوش مصنوعی است که با آموزش مدلهای LLM توانایی اجرای کد در نوتبوکهای Jupyter را دارد، امکان تحلیل دادههای پیچیده را به شیوهای تعاملی فراهم میکند.
 پژوهش
هوش مصنوعی بدون GPU: چگونگی افزایش کارایی با vLLM هممحور در TRL
این مقاله روش Co‑Located vLLM در TRL را معرفی و نشان میدهد چگونه با استفاده از GPUهای مشترک، کارایی مدلهای LLM را بدون هزینه اضافی به حداکثر میرساند.
 پژوهش
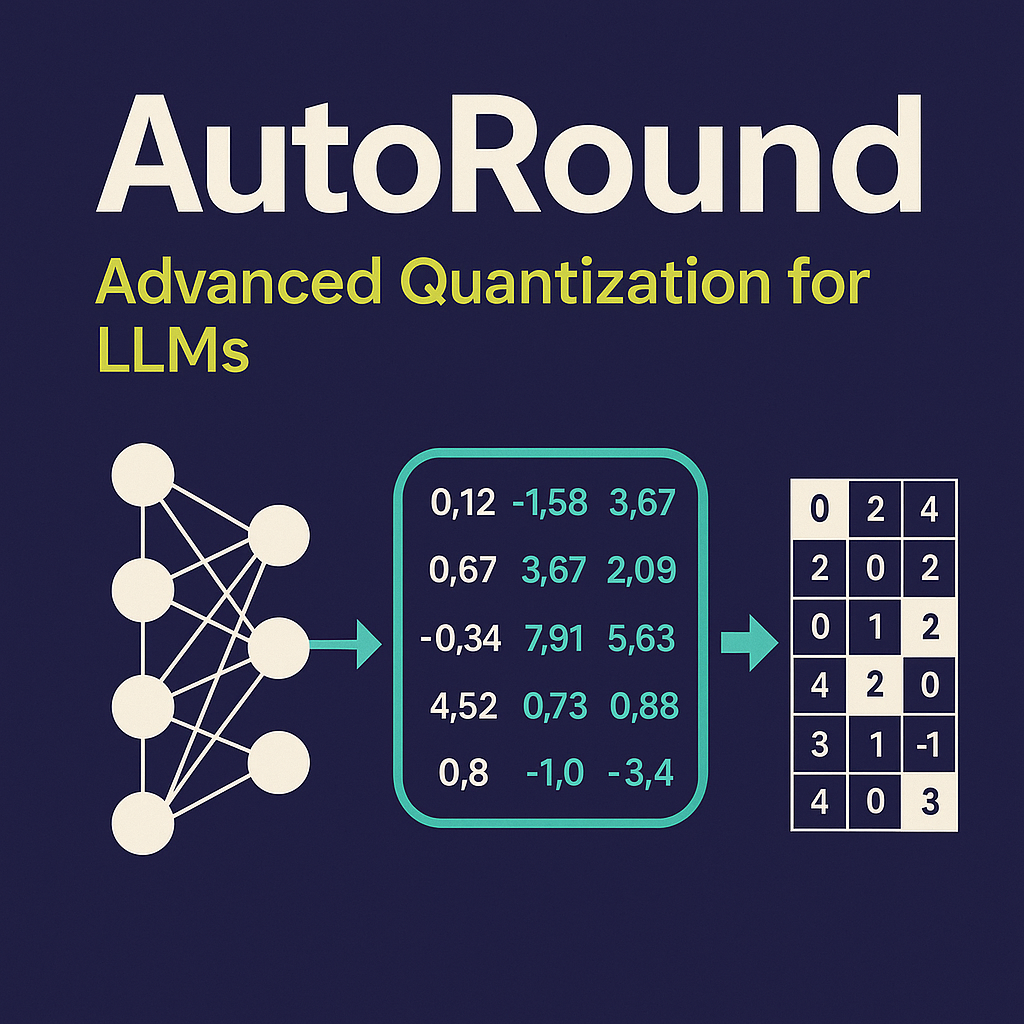
هوش مصنوعی: AutoRound شرکت اینتل برای کمینهسازی مدلهای LLM و VLM
AutoRound از اینتل، یک ابزار کوانتایزیشن وزن-فقط برای LLMs و VLMs است که با دقت بالا در بیتهای 2 تا 8، حجم مدل را تا ۳۰٪ کاهش میدهد.