
 مدلها
معرفی JAT؛ هوش مصنوعی همهکاره Hugging Face برای محیطهای متنوع
مدل JAT یک عامل چندمنظوره هوش مصنوعی است که با دادههای تخصصی از محیطهایی مانند Atari، BabyAI، Meta-World و MuJoCo آموزش دیده و اکنون بهصورت متنباز در دسترس است
 پژوهش
نحوه دو بار سریعتر کردن آموزش مدلهای LLM با Unsloth و 🤗 TRL در دنیای هوش مصنوعی
Unsloth، کتابخانهٔ سبکوزن همراه با 🤗 TRL، عکسالعمل دو مراتبهٔ سریعتر آموزش LLM را با کاهش مصرف حافظهٔ ۴۰٪ و بدون افت دقت ارائه میدهد؛ برای علاقهمندان به هوش مصنوعی بخوبی عمل میکند.
 پژوهش
پیادهسازی RLHF با PPO: بازتولید کد OpenAI و نکات کلیدی
این مقاله به تفصیل جزئیات پیادهسازی یادگیری تقویتی با بازخورد انسانی (RLHF) در چارچوب PPO را بررسی میکند و از بازتولید کدهای OpenAI بهره میگیرد.
 محصولات
Gradio Lite: اجرای بدون سرور در مرورگر با هوش مصنوعی—راهحلی سریع برای توسعه مدلها
Gradio Lite با استفاده از Pyodide به شما امکان میدهد نرمافزارهای هوش مصنوعی Gradio را بهصورت کاملاً سرورسور (Serverless) در مرورگر اجرا کنید. این تکنولوژی سرعت، حریمخصوصی و سهولت انتشار را بهبود میبخشد۔
 پژوهش
همراه با هوش مصنوعی: آموزش فاینتوینس پیشرفته Stable Diffusion با DDPO و TRL
در این مقاله، نحوهی استفاده از الگوریتم DDPO در فاینتوینس مدلهای Stable Diffusion را با ابزار TRL توضیح میدهیم. کارایی نسبت به سامانههای سنتی نشان داده شده است.
 پژوهش
هوش مصنوعی در لامّا ۲: آموزش مستقیم با DPO و سادهسازی RLHF
در این مقاله، نحوهی آموزش مستقیم لامّا ۲ با روش DPO در Hugging Face بررسی میشود؛ سادهسازی یادگیری بازخورد انسانی و مزایای آن توضیح داده میشود.
 پژوهش
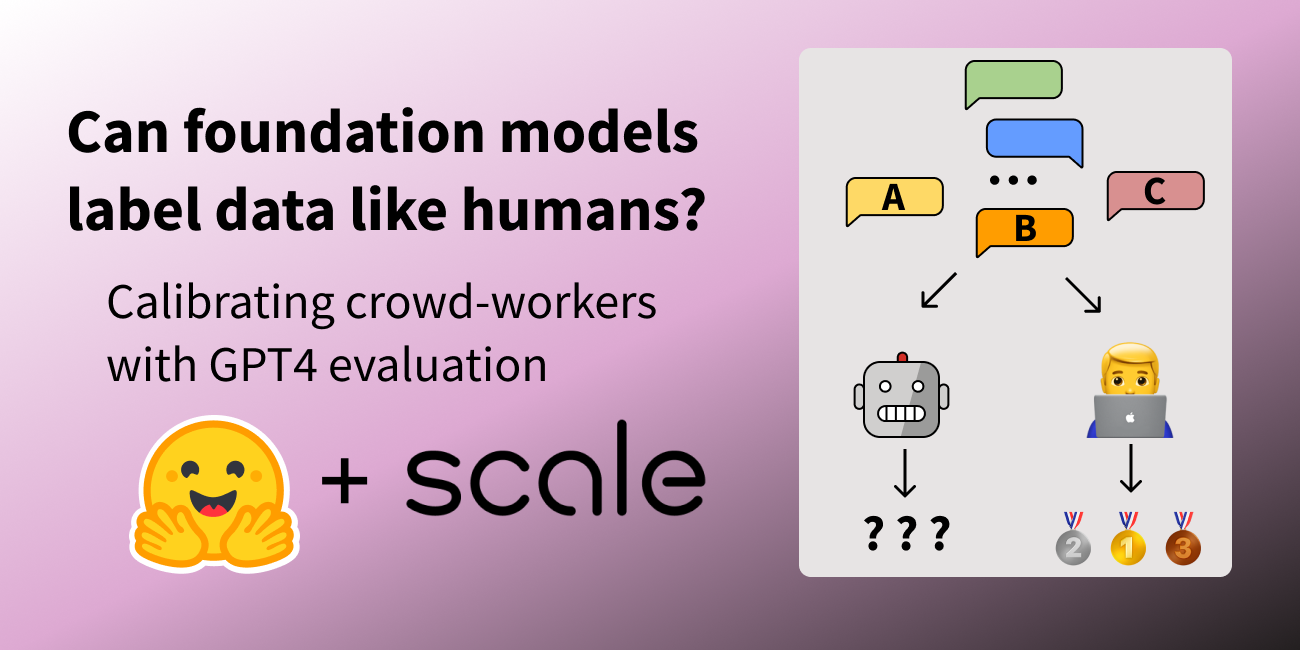
آیا مدلهای بنیادی هوش مصنوعی میتوانند دادهها را مانند انسان برچسبگذاری کنند؟
هوش مصنوعی و برچسبگذاری داده: بررسی میکند که آیا مدلهای بنیادی قادر به تشخیص و اولویتبندی دادهها مانند انسان هستند یا خیر. مقایسه نتایج مدلها با قضاوت انسانی در سنجش کارایی آنها.
 پژوهش
یکپارچگی BERTopic با هاب Hugging Face؛ پیشرفتی در مدلسازی موضوعی هوش مصنوعی
BERTopic اکنون به Hugging Face Hub متصل شده است؛ امکان ذخیره و بارگذاری مدلهای موضوعی با safetensors فراهم شده و گامی در جهت دموکراتیزه کردن هوش مصنوعی است.
 پژوهش
هوش مصنوعی با StackLLaMA: آموزش عملی دستنشان برای آموزش LLaMA با RLHF
مقالهی StackLLaMA را برای آموزش LLaMA با RLHF دستهبندی میکند؛ مراحل ساده، چالشها، و راهحلهای عملی، نمونهای برای ارتقاء و دموکراتیزهسازی AI.
 پژوهش
هوش مصنوعی: آموزش فاینتیونینگ 20B مدل با RLHF روی کارت گرافیک 24GB
در این مقاله، به بررسی آموزش فاینتیونینگ 20B مدل زبانی با یادگیری تقویتی (RLHF) روی کارت گرافیک 24GB پرداختهایم و نکات کلیدی را در راهحلهای متنباز پوشش میدهیم.