
 پژوهش
هوش مصنوعی میشود سریعتر: پارکت CDC کپیپذیری دادهای را کاهش میدهد
با معرفی Content‑Defined Chunking (CDC) در فایلهای Parquet، سرعت بارگذاری و دانلود در Hugging Face Hub چشمگیر کاهش مییابد؛ این فناوری در PyArrow و Pandas فعال میشود و صرفهجویی عظیمی در مصرف داده ایجاد میکند.
 پژوهش
هوش مصنوعی: راهحلی پیشرفته برای پردازش دادههای چندرسانهای برای آموزش و تولید متن
در این مطلب به معرفی پنج مرحلهٔ بهینه برای ساخت پایپلاین داده چندرسانهای در Hugging Face میپردازیم و تاثیر آن بر کاهش مصرف GPU و هزینه را بررسی میکنیم.
 سیاست و قانون
چگونه به درخواستهای نیویورک تایمز برای دسترسی به دادهها به منظور محافظت از حریم خصوصی کاربران پاسخ میدهیم؟
شرکت OpenAI به درخواست نیویورک تایمز و شاکیان، در حال مبارزه با حکم دادگاه است که شامل نگهداری نامحدود دادههای کاربران ChatGPT و API مصرفکنندگان میشود. بیا
 کسبوکار
SmolVLA: هوش مصنوعی شیفته چشمانداز-زبان-عمل، مدل کم حجم و قدرتمند
مدل SmolVLA، یک مدل چشمانداز-زبان-عمل کوچک (450M پارامتر) که با دادههای جامعهی Lerobot در هوش مصنوعی روباتیک آموزش دیده و بر روی سختافزار مصرفکننده قابل اجرا است
 پژوهش
هوش مصنوعی در Liger GRPO: تقویت TRL با بهینهسازی حافظه و مقیاسپذیری
در این خبر، Liger GRPO با کاهش مصرف حافظه ۴۰٪ و افزودن امکانات FSDP و PEFT، آموزش RL را برای مدلهای بزرگ بهینه میکند و به تسهیل مقیاسپذیری در چند گپ تبدیل میشود.
 پژوهش
کوانتایزاسیون Diffusers: هوش مصنوعی را سریعتر و ارزانتر میکند
کـوانتایزاسیون در Diffusers مدلهای Flux را تا 80٪ فشرده میکند و مصرف حافظه را کاهش میدهد، در حالی که کیفیت تصویر تقریباً همانند نسخهٔ بالا باقی میماند.
 پژوهش
هوش مصنوعی و Prefill - راهکارهای بهینهسازی پردازش موازی در LLM
در این گزارش به بررسی استراتژیهای Prefill و Decode برای پردازش موازی در مدلهای زبانی بزرگ میپردازیم، تمرکز بر بهینهسازی تاخیر، Throughput و مصرف GPU.
 پژوهش
بهینهسازی صف درخواست در هوش مصنوعی: سروری هوشمند برای بارگذاری موازی مدلها
در این مقاله به چالشهای همزمانسازی دسترسی به مدلهای بزرگ زبان پرداخته و راهکارهای صفبندی عادلانه، مانع از بلوک شدن کاربران قدرتمند و بهینهسازی مصرف GPU میشود برای بهبود کارایی و بهرهوری شبکههای هوش مصنوعی.
 مدلها
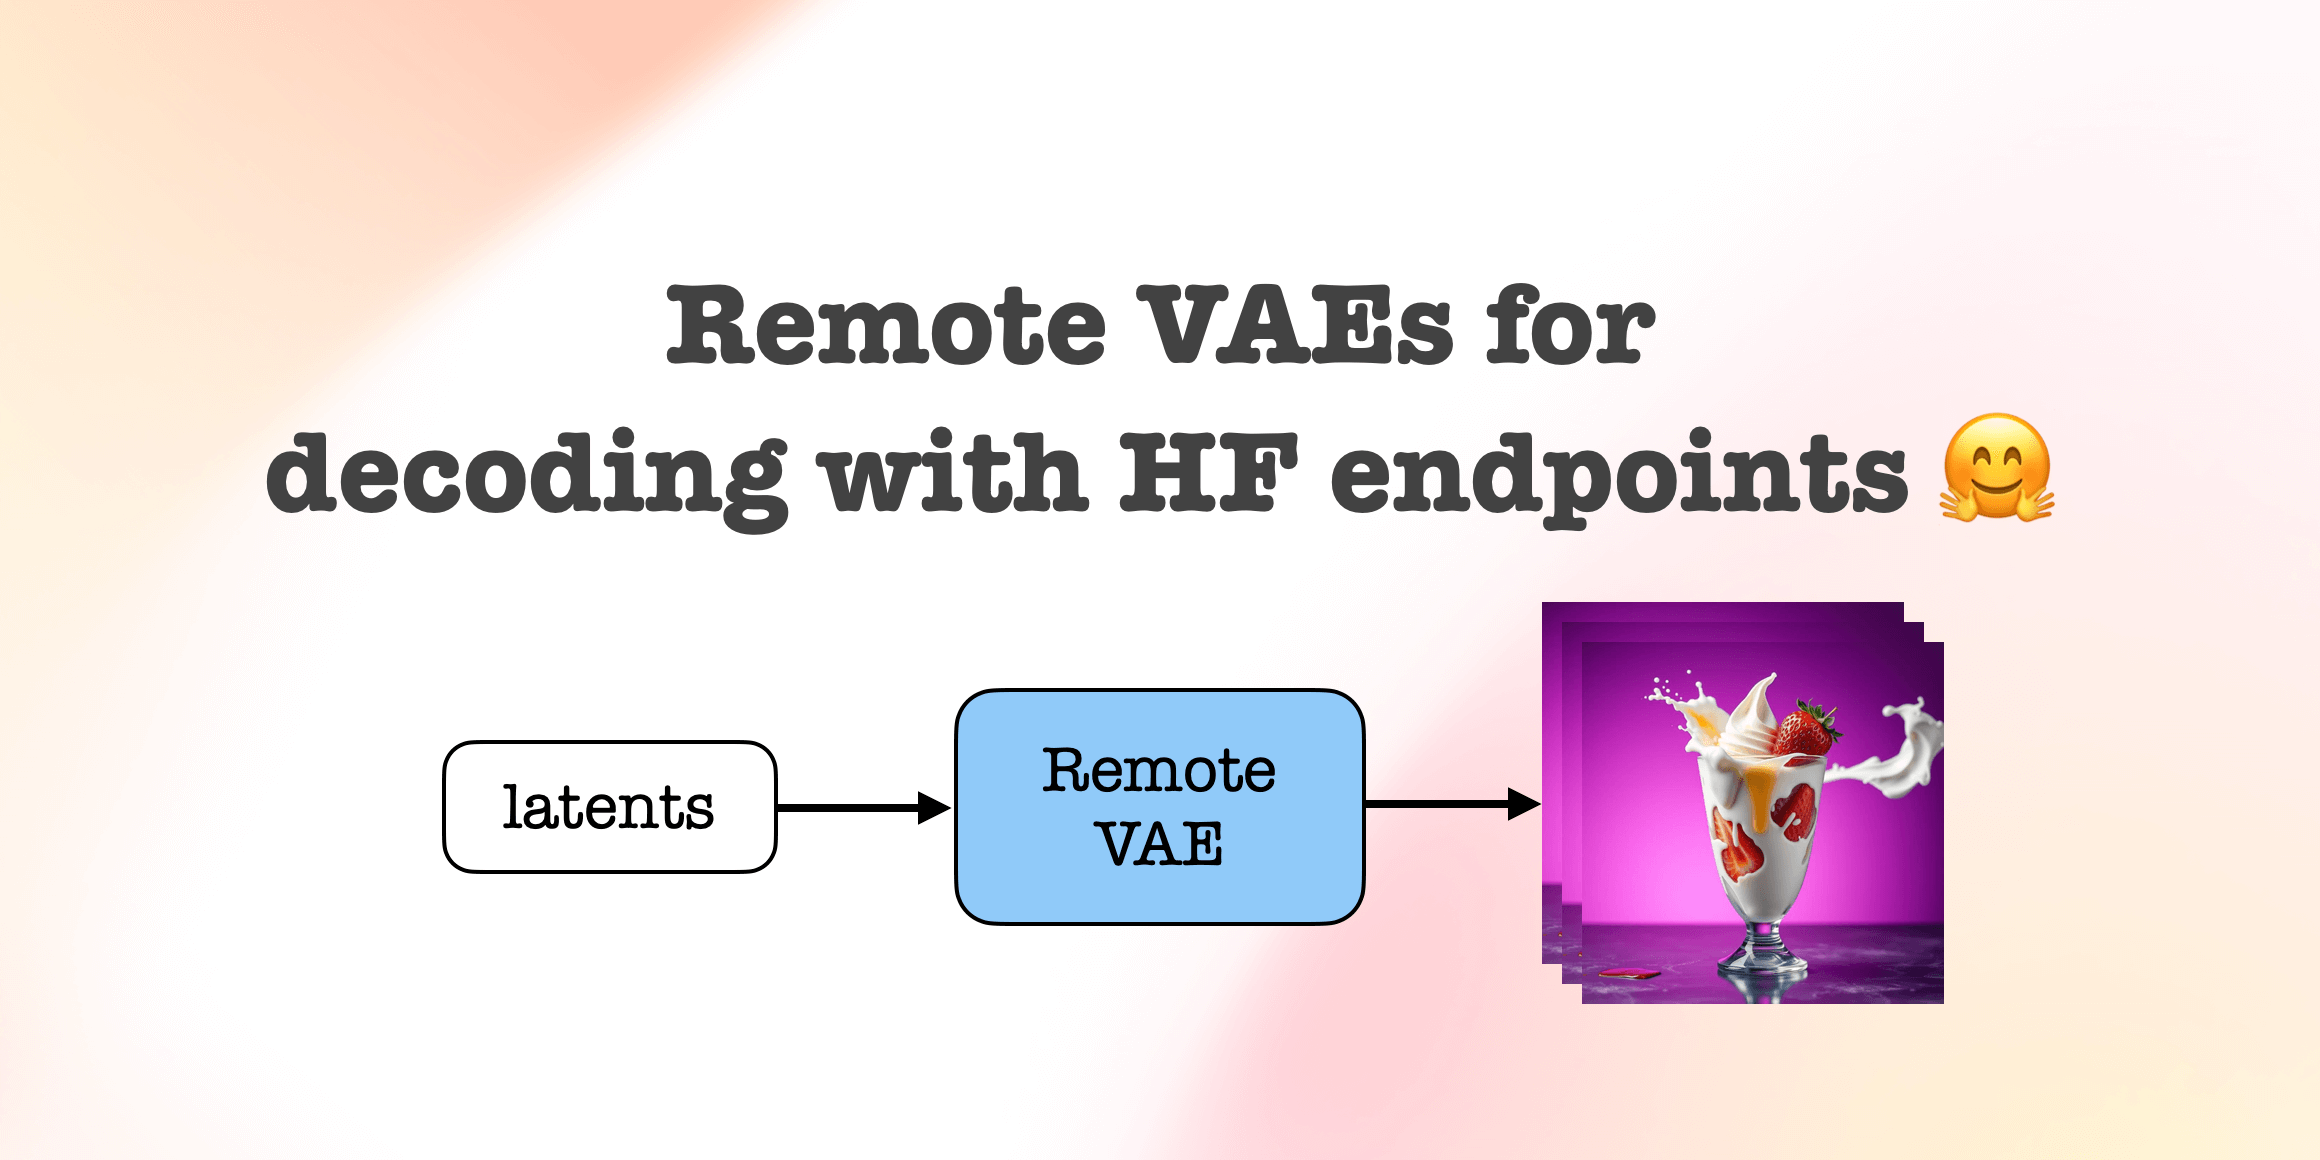
هوش مصنوعی با Remote VAE ها: تسهیل پردازش تصویر با اِندپوینت خارج از سازمان
Hugging Face با Remote VAE، پردازش دیسک‑کدینگ تصاویر و ویدیوها را با مصرف حافظه کمتر و سرعت بالاتر با استفاده از Endpoints ارائه میکند.
 مدلها
SmolVLM2: هوش مصنوعی درک ویدیو برای هر دستگاه
SmolVLM2 هوش مصنوعی جدیدی از Hugging Face است که با مدلهای کمحجم و مصرف پایین، درک ویدیو را در دستگاههای همهکاره و محدود منابع قابل اجرا میکند و امکان استفاده آسان از هوش مصنوعی برای تجزیه و تحلیل ویدیو فراهم میآورد.