
 محصولات
هوش مصنوعی سریع: معرفی مدل جدید Holo3.1 از H Company و امکانات محلی
چطور Holo3.1، عامل محاسباتی سریع و محلی، با بهینهسازی هزینه و عملکرد، در محیطهای دسکتاپ و موبایل بهطور یکپارچه کار میکند؟
 پژوهش
هوش مصنوعی در دقت بالا: چرخش زمان با torch.profiler در پایتورچ
در این مقاله، به بررسی ابزار torch.profiler در پایتورچ میپردازیم و نکات کلیدی برای پروفایلینگ مدلهای هوش مصنوعی و بهینهسازی سرعت ارائه میکنیم. با این گامها، توسعه دهندگان میتوانند عملکرد مدلهای خود را به طور قابل توجهی بهبود بخشند.
 مدلها
هوش مصنوعی در ردهبندی: معرفی Ettin Reranker Family مدلهای برتر
در این گزارش به معرفی شش مدل ردهبندی مبتنی بر Sentence Transformers در خانواده Ettin رندرها میپردازیم؛ با سبک بندی و distillation، عملکرد برشی بر MTEB(eng,v2) و سایر نگهدارندگان نشان میدهد.
 مدلها
Granite R2: مدل هوش مصنوعی چندزبانه با 32K تناظر و سرعت بالا
در این مقاله به معرفی جدیدترین مدل embedding چندزبانه Granite R2 میپردازیم؛ با 32k توکن، 200+ زبان و عملکرد برتر در MTEB، صنعت جستجو و retrieval را تغییر میدهد.
 پژوهش
هوش مصنوعی با GPT-5.5 Instant: کارت سیستم جامع و بهروز
OpenAI با انتشار کارت سیستم جدید GPT‑5.5 Instant، تعاریف دقیق عملکرد، محدودیتهای امنیتی و روشهای استفاده مسئولانه را بهصورت شفاف در اختیار کاربران قرار داد. این گام مهمی در شفافسازی هوش مصنوعی محسوب میشود.
 پژوهش
نVIDIA Nemotron 3 Nano Omni؛ هوش مصنوعی چندرشتهای با زمینههای طولانی
پیشروترین هوش مصنوعی چندرشتهای NVIDIA Nemotron 3 Nano Omni با قابلیت تحلیل متن، تشخیص گفتار و درک طولانی ویدئو در قالب مدل چندرسانهای پیشرفته، همچنین عملکرد بالا در بسترهای تجاری را به ارمغان میآورد.
 کسبوکار
کاربرد ChatGPT در تیمهای بازاریابی: راهنمای جامع هوش مصنوعی برای رشد کسبوکار
کشف کنید که چگونه تیمهای بازاریابی میتوانند از ChatGPT برای برنامهریزی کمپینها، تولید محتوا، تحلیل عملکرد و تبدیل دادهها به اقدام مؤثر بهره ببرند. با هوش مصنوعی، بازاریابی خود را متحول کنید.
 پژوهش
هوش مصنوعی: چگونه کِرنلهای CUDA سفارشی برای Codex و Claude ساخته میشود
نجومیترین راهحل برای توسعه و بهاشتراکگذاری کِرنلهای CUDA سفارشی توسط هوش مصنوعی. این مقاله روند ساخت، تست و انتشار عملکرد را توضیح میدهد.
 اخبار
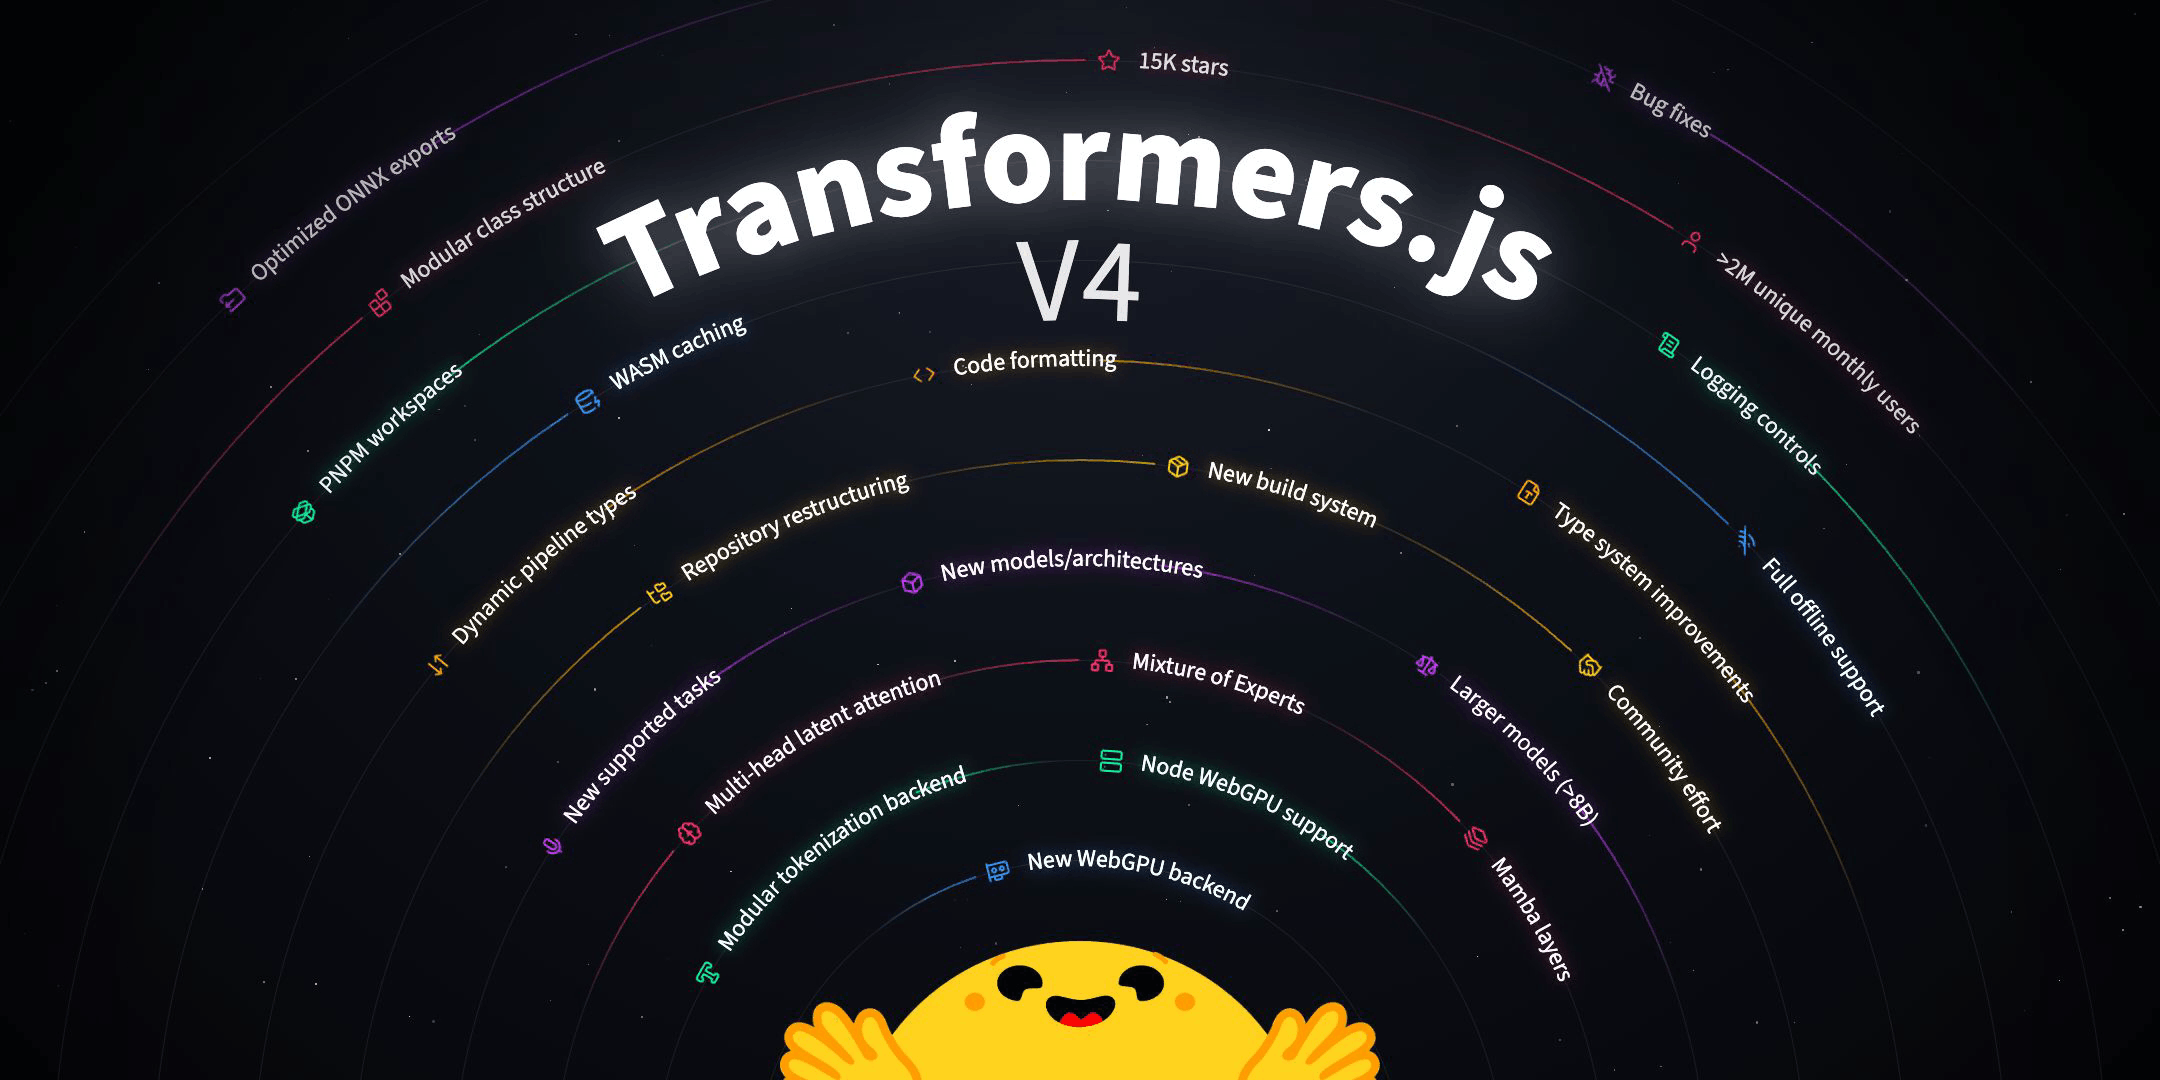
ترنسفورمرز.js v4: سرور جدید، سرعت بیسابقه و سازگاری بالا در هوش مصنوعی
حذف نسخه 4 ترنسفورمرز.js به راحتی روی npm نصب میشود، با رانتایم WebGPU جدید کارایی را به حداکثر میرساند و با جداول و ساختارهای جدید، مدلهای هوش مصنوعی را در مرورگر و سرور تأیید میسازد.
 پژوهش
هوش مصنوعی در OpenAI: ساخت و عملکرد یک ایجن داده داخلی با GPT‑5 و Codex
OpenAI با بهرهگیری از مدل GPT‑5، Codex و حافظه، یک ایجن داده داخلی طراحی کرده که در چند دقیقه نتایج قابل اطمینان از حجم عظیم دادهها استخراج میکند.