
 پژوهش
هوش مصنوعی در عربی: روند نوین ارزیابی کیفیت مدلهای LLM – راهنمای QIMMA
معرفی QIMMA، لواردبورد پیشرفتهٔ عربی با پردازش کیفیت بیخطا، موجب دستکاری دقیقتر نتایج ارزیابی مدلهای زبانی عربی میشود.
 پژوهش
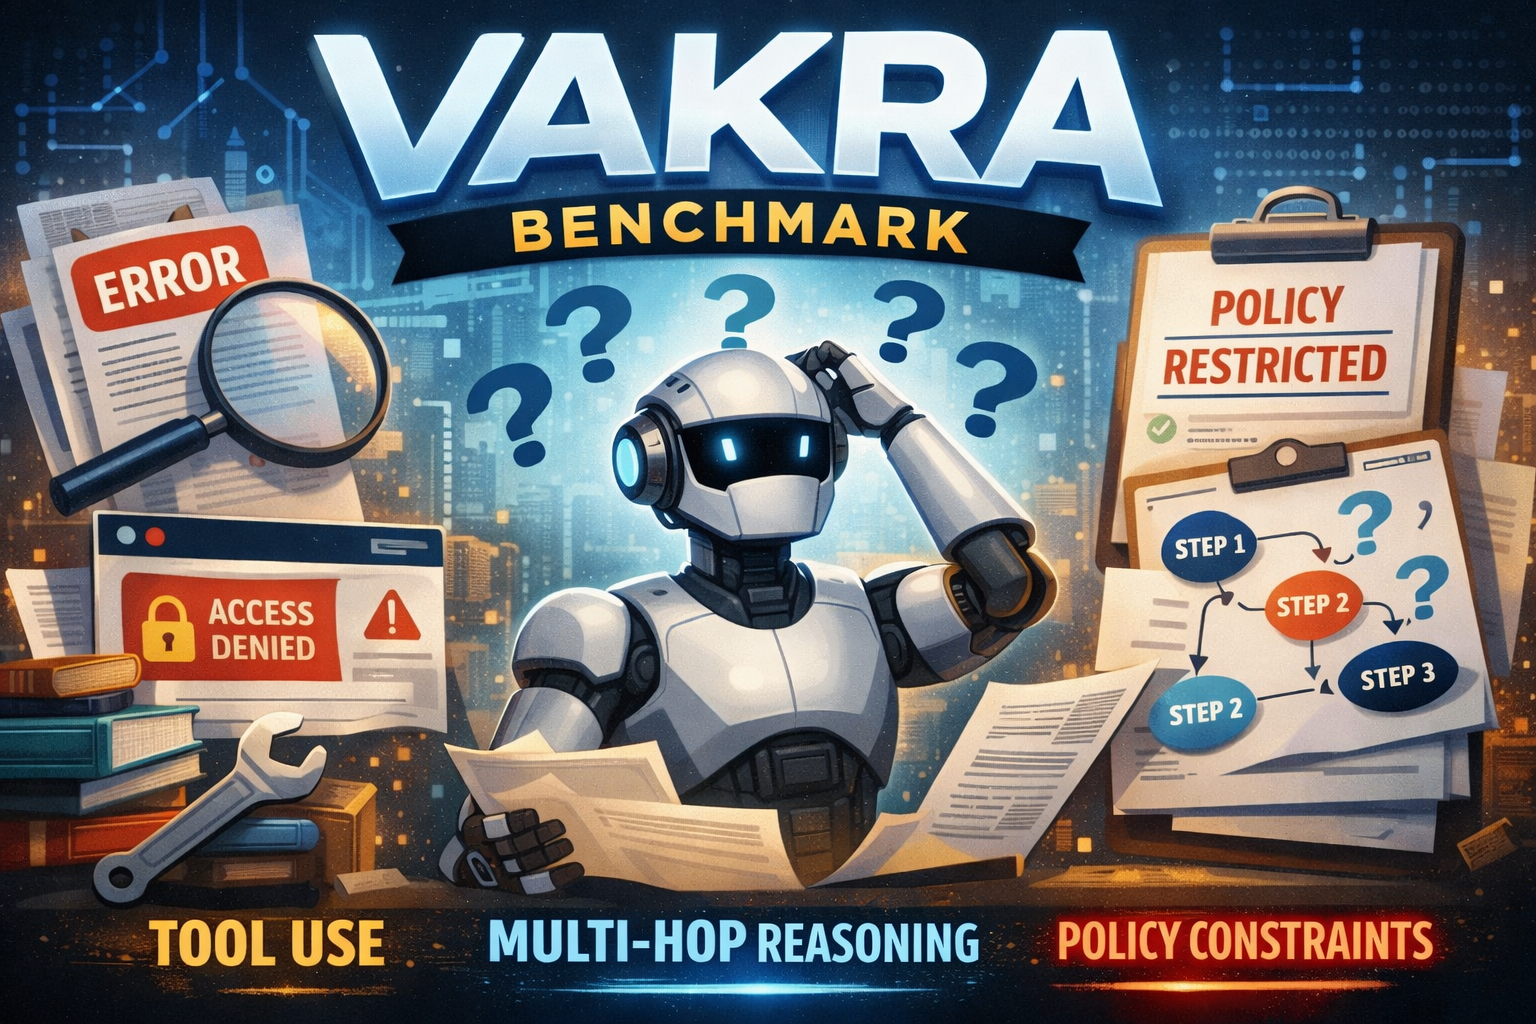
هوش مصنوعی در عمل: VAKRA، یک استاندارد جدید برای ارزیابی عاملها
معرفی VAKRA، بئندمارک جدیدی که توانایی هوش مصنوعی در ترکیب APIs و دادههای مستند را در محیطهای شبیهسازی کسبوکار ارزیابی میکند، بهدنبال روشهای دقیق و شفاف
 اخبار
چارچوبی جدید برای ارزیابی عاملهای صوتی (EVA)
یک پست وبلاگ از ServiceNow-AI در مورد بغل کردن صورت
 پژوهش
حفظ اوج سرمایهگذاری: چگونه Balyasny هوش مصنوعی را برای تحقیقات سرمایهگذاری ایجاد کرد
Balyasny Asset Management با ترکیب ارزیابی دقیق مدل، استفاده کامل از پلتفرم OpenAI و جریانکارتهای عامل، توانسته موتور پژوهش هوش مصنوعی راهاندازی کند که در تصمیمگیریهای سرمایهگذاری نقشی بینظیر ایفا میکند.
 آموزش
هوش مصنوعی در آموزش: ابزار، گواهینامه و راهکارهای جدید اوپنای برای شکاف مهارتی
OpenAI ابزارها، گواهینامه و منابع ارزیابی جدید برای مدارس و دانشگاهها معرفی کرد تا شکاف مهارتی هوش مصنوعی را کاهش داده و فرصتهای شغلی گستردهتری ایجاد کند.
 پژوهش
هوش مصنوعی در آموزش: بررسی مجموعهٔ سنجش نتایج یادگیری OpenAI
OpenAI با معرفی ‘Learning Outcomes Measurement Suite’، ابزار نوینی را عرضه کرده که تأثیر هوش مصنوعی را بر یادگیری دانشآموزان در محیطهای آموزشی مختلف طولانی مدت ارزیابی میکند.
 پژوهش
چرا دیگر SWE‑Bench Verified را ارزیابی نمیکنیم: محدودیتها و جایگزین
OpenAI اعلام کرده است که دیگر از SWE‑Bench Verified برای ارزیابی پیشرفت کدنویسی استفاده نمیکند؛ زیرا آزمایشات فاسد، نشت دادهها و اندازهگیری نادرست دارد.
 پژوهش
هوش مصنوعی در عمل: ارزیابی عاملان ابزارپسند با چارچوب OpenEnv
چارچوب OpenEnv توسط Meta و Hugging Face معرفی شد و به عنوان استانداردی برای آزمایش عاملهای هوش مصنوعی، تعاملشان با ابزارهای واقعی در محیطهای پیچیده را امکانپذیر میکند.
 پژوهش
هوش مصنوعی: ارزیابیهای جامعه باعث تغییر لیستهای بیتی میشود
با معرفی Community Evals، Hugging Face به دنبال ایجاد شفافیت در ارزیابی مدلهای هوش مصنوعی است. لیستهای بیشالصداقه دور میشوند و نتایج با اعتبار معتبر میکنند.
 پژوهش
هوش مصنوعی در ارزیابی لهجه اماراتی: پایگاه جدید Alyah برای مدلهای عربی
در این مقاله به بررسی پایگاه آنلاین Alyah میپردازیم که به پژوهشهای گویش اماراتی در مدلهای عربی میپردازد و نتایج ارزیابی از طریق Hugging Face را معرفی میکند.