
 محصولات
چگونه NVIDIA NIM سهلسازی میکند انتشار سریع LLM ها بر روی HuggingFace
بهروزرسانی جدید NVIDIA NIM در Hugging Face، امکان استقرار سریع 100,000+ مدل LLM را با یک میکروسرویس در یک کانتینر داکر فراهم میکند.
 محصولات
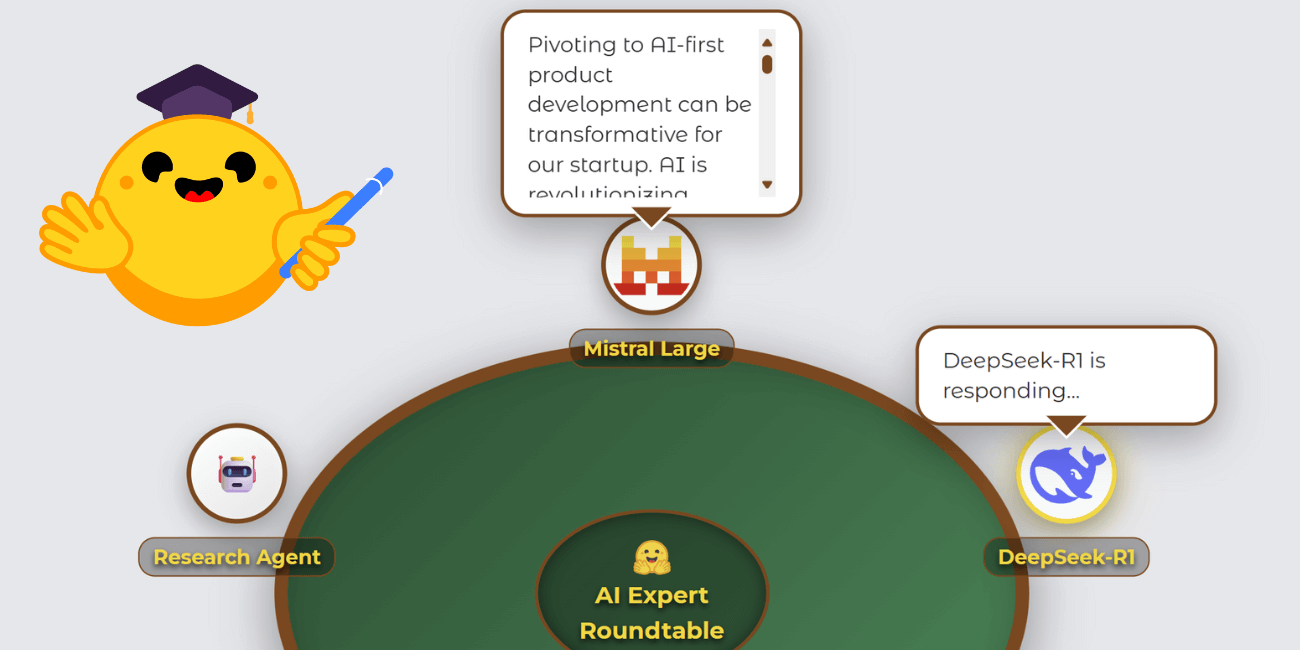
Consilium: پلتفرم هوش مصنوعی چند مدل برای تصمیمگیری مشترک
Consilium پلتفرم هوش مصنوعی چند مدل است که LLMها را برای بحث و تصمیمگیری هماهنگ میکند؛ در این مقاله به کاربردهای آن میپردازیم.
 پژوهش
هوش مصنوعی Ettin Suite: مدلهای Encoder-Decoder در سطح جدید
Ettin Suite، یک مجموعه بازمتداول جدید، با روشهای مدرن آموزش، Encoder-Only ModernBERT و Decoder-Only مدلی برتر از Llama 3.2 و SmolLM2 ارائه میدهد؛ این پیشرفت، احتمالا مسیر هوش مصنوعی را تغییر خواهد داد.
 مدلها
SmolLM3: مدلی چندزبانه با زمینه طولانی و قابلیت استدلال هوش مصنوعی
SmolLM3 یک مدل با حجم کم، چندزبانه و استدلالی برای متنهای طولانی است که در Hugging Face بهصورت open-source ارائه میشود و قابلیت پیادهسازی سریع در اپلیکیشنها را دارد.
 پژوهش
هوش مصنوعی: رقابت E2LM 2025 – ارزیابی زودهنگام مدلهای زبانی
در قالب جدید پیشآموزش مدلهای زبانی، رقابت E2LM 2025 مهندسان را میطلبد؛ نتایج در NeurIPS 2025 اعلام خواهد شد با سه ماه برای ثبتنام
 پژوهش
هوش مصنوعی: چگونه پرامپتهای طولانی صفهای پیشبینی را مسدود میکنند
در این مقاله به بررسی چالشهای پرامپتهای طولانی در مدلهای زبان بزرگ و راهحلهای پیشنهادی برای بهبود تأخیر و کارایی پرداختهایم.
 پژوهش
هوش مصنوعی بدون GPU: چگونگی افزایش کارایی با vLLM هممحور در TRL
این مقاله روش Co‑Located vLLM در TRL را معرفی و نشان میدهد چگونه با استفاده از GPUهای مشترک، کارایی مدلهای LLM را بدون هزینه اضافی به حداکثر میرساند.
 پژوهش
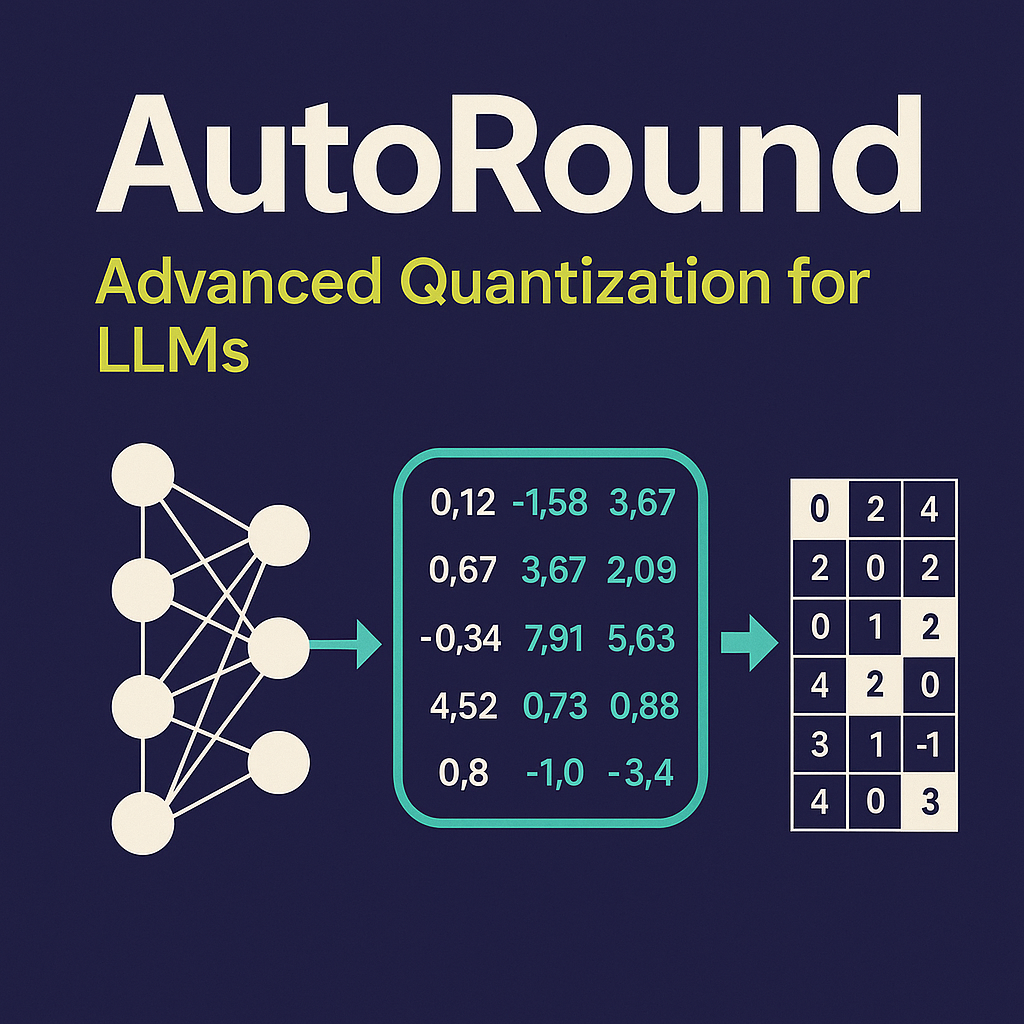
هوش مصنوعی: AutoRound شرکت اینتل برای کمینهسازی مدلهای LLM و VLM
AutoRound از اینتل، یک ابزار کوانتایزیشن وزن-فقط برای LLMs و VLMs است که با دقت بالا در بیتهای 2 تا 8، حجم مدل را تا ۳۰٪ کاهش میدهد.
 پژوهش
هوش مصنوعی در 50 خط: Tiny Agents و بالاتر بردن قابلیت MCP
Tiny Agents، یک عامل ۵۰ خطی که با پروتکل MCP قدرت فراخوانی ابزارهای LLM را بهصورت متن باز و سبک در دنیای هوش مصنوعی ارائه میدهد.
 پژوهش
هوش مصنوعی و Prefill - راهکارهای بهینهسازی پردازش موازی در LLM
در این گزارش به بررسی استراتژیهای Prefill و Decode برای پردازش موازی در مدلهای زبانی بزرگ میپردازیم، تمرکز بر بهینهسازی تاخیر، Throughput و مصرف GPU.