
 پژوهش
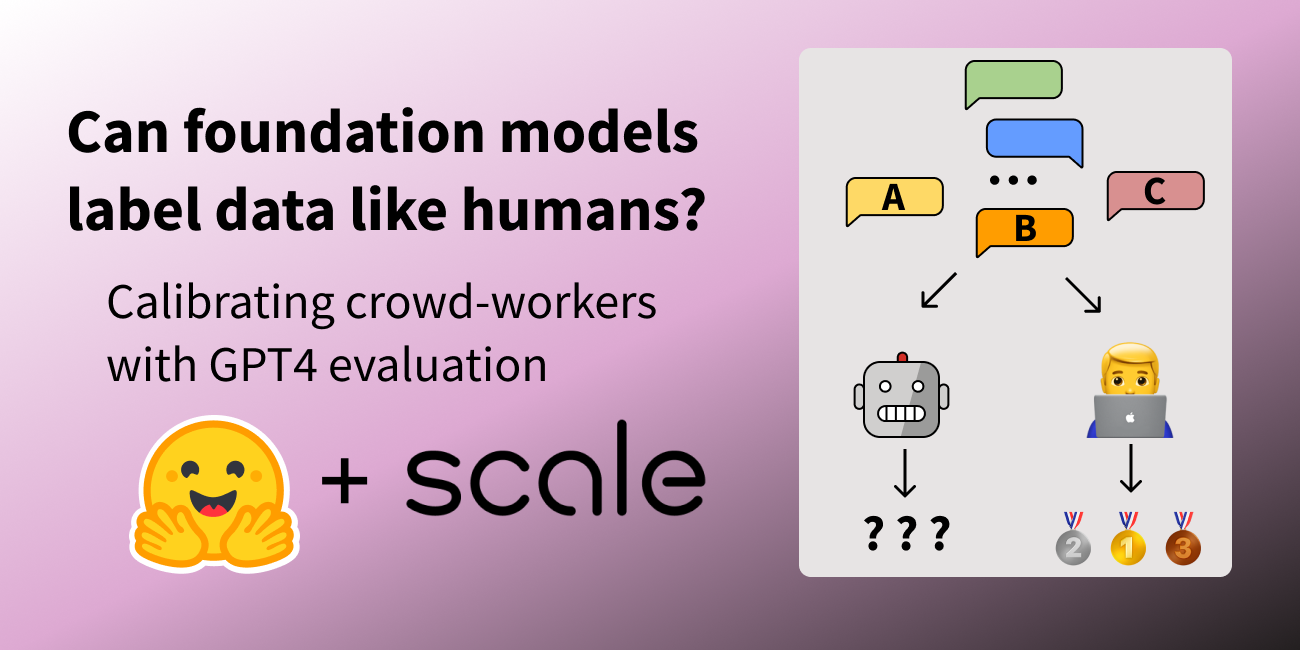
آیا مدلهای بنیادی هوش مصنوعی میتوانند دادهها را مانند انسان برچسبگذاری کنند؟
هوش مصنوعی و برچسبگذاری داده: بررسی میکند که آیا مدلهای بنیادی قادر به تشخیص و اولویتبندی دادهها مانند انسان هستند یا خیر. مقایسه نتایج مدلها با قضاوت انسانی در سنجش کارایی آنها.
 پژوهش
هوش مصنوعی: چگونه مدلهای بزرگ زبانی بدون نمونهچین آزمایش شوند
این مقاله به بررسی روشهای بدون نمونهچین (Zero‑Shot) برای ارزیابی مدلهای زبان عظیم در هاب هوش مصنوعی میپردازد و ابزارهای جدید را معرفی میکند.
 پژوهش
هوش مصنوعی را با Evaluation on the Hub ارزیابی کنید – راهنمای جامع اوپنسورس
معرفی Evaluation on the Hub، ابزار جدید اوپنسورس برای ارزیابی مدلهای هوش مصنوعی بدون نوشتن کد، توضیحات کاربردی، مراحل عملی و نکات کلیدی.
 پژوهش
ارزیابی مدلهای زبانی بزرگ آموزشدیده روی کد؛ رویکرد نوین OpenAI
در این مقاله به بررسی روشهای ارزیابی مدلهای زبانی بزرگ متخصص در کدنویسی میپردازیم و معیار HumanEval و اهمیت آن را برای سنجش هوش مصنوعی کدنویس تحلیل میکنیم.