
 مدلها
رونمایی StarCoder2؛ خانواده جدید مدلهای هوش مصنوعی متنباز برای کدنویسی
StarCoder2 خانواده مدلهای متنباز هوش مصنوعی برای کدنویسی است؛ با سه اندازه ۳، ۷ و ۱۵ میلیارد پارامتر و آموزش روی ۴ تریلیون توکن و ۶۰۰+ زبان.
 پژوهش
آموزش تنظیم دقیق مدلهای جما با هوش مصنوعی در Hugging Face
در این مقاله، روش تنظیم دقیق کارآمد پارامتر (PEFT) مدلهای جما را با کتابخانههای Hugging Face روی GPU و TPU میآموزیم؛ راهکاری نوین برای سفارشیسازی هوش مصنوعی.
 آموزش
آموزش گامبهگام PatchTST در Hugging Face؛ از پیشبینی تا انتقال یادگیری
با PatchTST در Hugging Face پیشبینی سریهای زمانی را بیاموزید؛ از آموزش روی داده برق تا انتقال یادگیری به ETTh1 با روشهای Zero-shot و Fine-tuning.
 مدلها
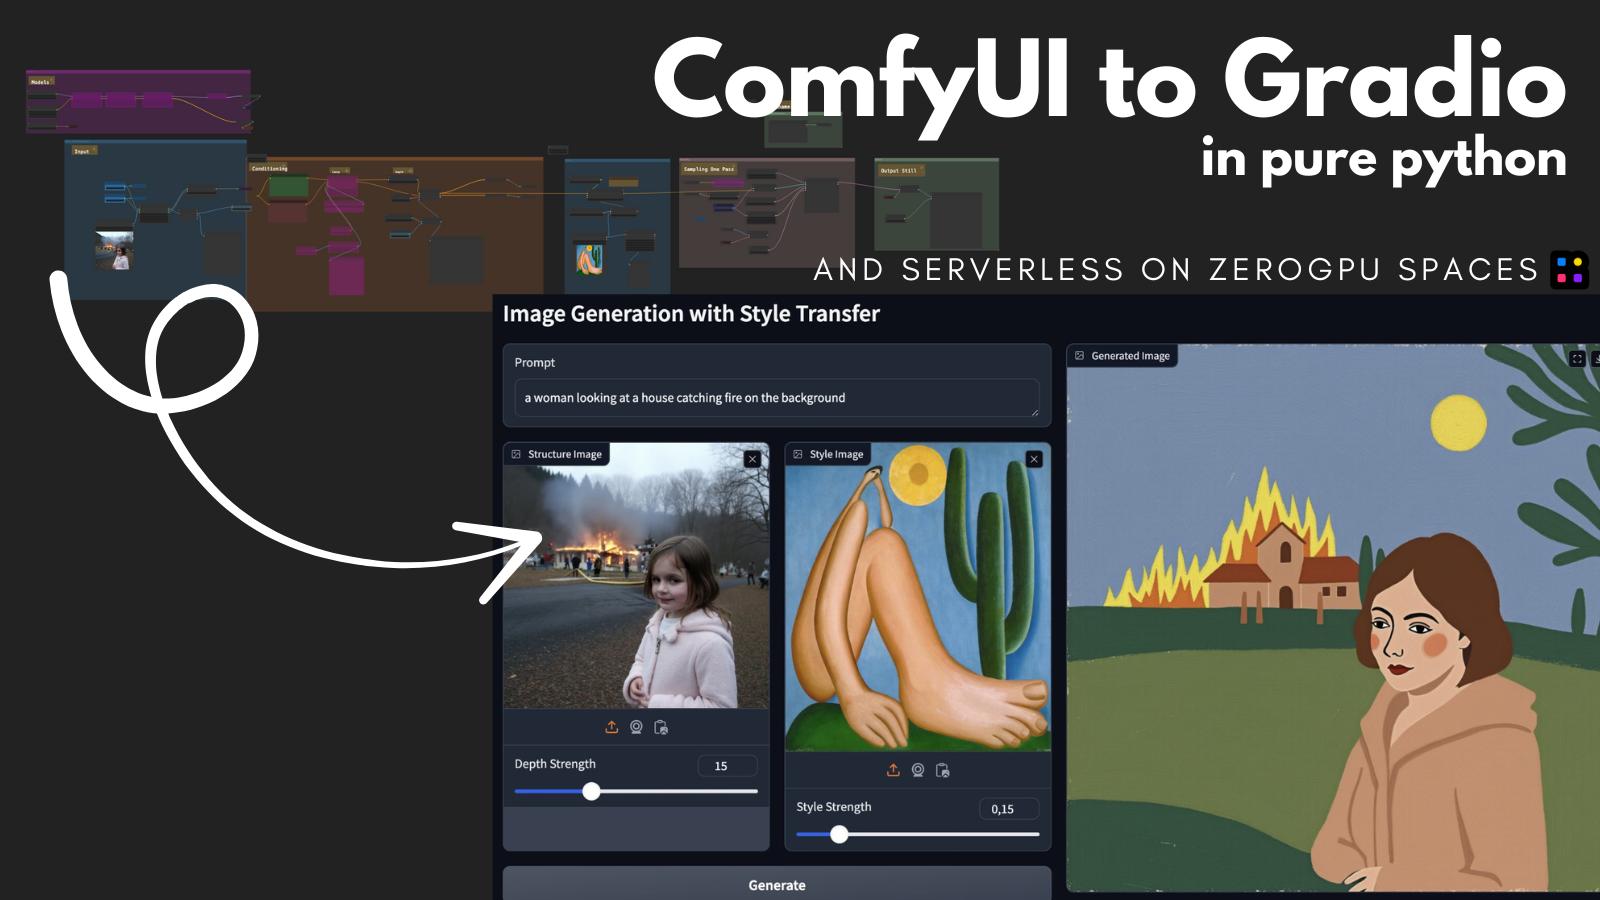
هوش مصنوعی در عمل: تبدیل ورکفلوهای ComfyUI به اپلیکیشن گراودری رایگان
در این مقاله، گامهای ساده تبدیل ورکفلو ComfyUI به گراودری و استقرار آزاد در Hugging Face ZeroGPU را بررسی میکنیم بهصورت ساده و بدون نیاز به سرور.
 پژوهش
ساخت لیدربورڈ هوش مصنوعی: گام به گام با Vectara و HHEM
راهنمای جامع نصب لیدربورڈ هوش مصنوعی در هاجینگ فیس با Vectara و امکان ارزیابی دقیق لسههای هالوژن در مدلهای LLM و مدلهای تجاری در مجتمع آموزشی.
 پژوهش
نحوه دو بار سریعتر کردن آموزش مدلهای LLM با Unsloth و 🤗 TRL در دنیای هوش مصنوعی
Unsloth، کتابخانهٔ سبکوزن همراه با 🤗 TRL، عکسالعمل دو مراتبهٔ سریعتر آموزش LLM را با کاهش مصرف حافظهٔ ۴۰٪ و بدون افت دقت ارائه میدهد؛ برای علاقهمندان به هوش مصنوعی بخوبی عمل میکند.
 مدلها
چطور نمره DROP به عملکرد مدلهای هوش مصنوعی را به چالش می‑کشاند
پژوهشی دقیق در Open LLM Leaderboard نشان داد که مدلهای پیشآموزشپذیر، در آزمون DROP، عملکردی کمتر از حد انتظار دارند؛ عواملی که این نتیجه را بیان میکنند و راهکارهای پیشنهادی در این مقاله بررسی شدهاند.
 محصولات
قاطعترین گام در هوش مصنوعی: Prodigy-HF، ادغام مستقیم با Hugging Face
تحلیل تازه از ادغام Prodigy-HF با Hugging Face، کدهای سفارشی و امکانات آموزشی برای توسعهدهندگان هوش مصنوعی و پژوهشگران در زمینه پردازش زبان طبیعی.
 پژوهش
پیادهسازی RLHF با PPO: بازتولید کد OpenAI و نکات کلیدی
این مقاله به تفصیل جزئیات پیادهسازی یادگیری تقویتی با بازخورد انسانی (RLHF) در چارچوب PPO را بررسی میکند و از بازتولید کدهای OpenAI بهره میگیرد.
 پژوهش
همراه با هوش مصنوعی: آموزش فاینتوینس پیشرفته Stable Diffusion با DDPO و TRL
در این مقاله، نحوهی استفاده از الگوریتم DDPO در فاینتوینس مدلهای Stable Diffusion را با ابزار TRL توضیح میدهیم. کارایی نسبت به سامانههای سنتی نشان داده شده است.