
 پژوهش
معاوضه قدرت محاسباتی و استحکام تهاجمی در هوش مصنوعی: راهکاری نوین
اوپنایآی رویکردی جدید برای مقابله با حملات تهاجمی به مدلهای هوش مصنوعی معرفی کرده است. این روش شامل افزایش محاسبات زمان استنتاج برای بهبود چشمگیر استحکام و امنیت مدلهاست.
 پژوهش
معرفی پشتیبانی چند-پشتیبان (TRT-LLM، vLLM) برای استنتاج تولید متن
ما در مسیر پیشرفت و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم آزاد هستیم.
 مدلها
یکپارچگی انقلابی Timm و Transformers: گامی نوین در هوش مصنوعی بینایی ماشین
یکپارچگی جدید کتابخانههای Timm و Hugging Face Transformers، بهرهوری مدلهای بینایی ماشین را افزایش میدهد. از استنتاج سریع تا تنظیم دقیق آسانتر، این همکاری دنیای AI را متحول میکند.
 پژوهش
ردپای کربن هوش مصنوعی: تحلیل انتشار CO2 مدلهای زبان بزرگ
گزارش هاگینگ فیس از لیدربورد Open LLM، نگاهی عمیق به انتشار CO2 مدلهای زبان بزرگ در فرآیند استنتاج ارائه میدهد. آگاهی از تأثیر زیستمحیطی هوش مصنوعی رو به افزایش است.
 سختافزار
اجرای هوش مصنوعی مولد روی لپتاپ: چتبات Phi-2 با پردازنده متئور لیک اینتل
هاگینگ فیس و اینتل اجرای مدل هوش مصنوعی Phi-2 را روی لپتاپهای مجهز به پردازنده متئور لیک ممکن کردهاند؛ گامی برای استنتاج محلی مدلهای زبانی بزرگ.
 پژوهش
هوش مصنوعی در دسترس: سرفصل راهنمای استقرار مدل LLM در Hugging Face
در این مقاله گام به گام میآموزیم چگونه مدلهای LLM را در نقاط استنتاج هفینگ فیس مستقر، تست و دریافت پاسخهای زنده کنیم در محیطی امن و مقیاسپذیر.
 اخبار
فالکون در هگینگ فیس: جهشی بزرگ برای هوش مصنوعی متنباز
مدلهای هوش مصنوعی فالکون، ساخته مؤسسه TII، با مجوز Apache 2.0 و قابلیتهای رقابتی، انقلابی در هوش مصنوعی متنباز ایجاد کردهاند. اکنون در Hugging Face در دسترسند.
 محصولات
کانتینر جدید Hugging Face برای استقرار مدلهای هوش مصنوعی در SageMaker
هانگینگ فیس کانتینر استنتاج جدیدی برای استقرار مدلهای زبانی بزرگ در Amazon SageMaker معرفی کرد. این راهکار بر پایه Text Generation Inference عملکردی بهینه و امن ارائه میدهد.
 مدلها
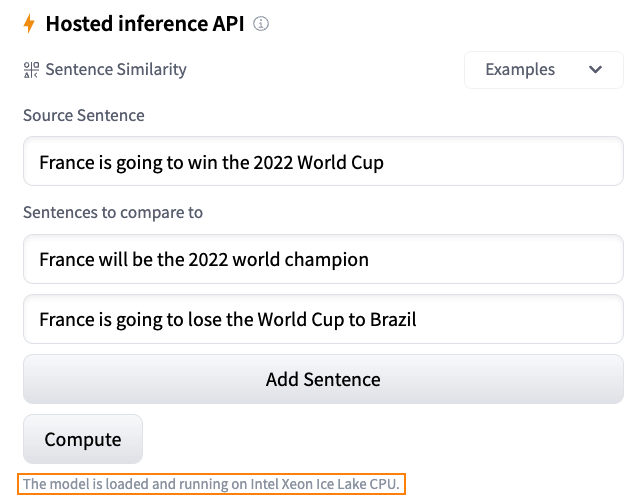
هوش مصنوعی در راهحلهای استنتاج: دیدگاههای Hugging Face و ادغام مدلها
این مقاله بهروز رسانیهای Hugging Face درباره راهحلهای استنتاج پیشرفته، ابزارها و قابلیتهای رایگان CPU، و ادغام مدلهای زبانی را بررسی میکند.
 اخبار
چگونه با هوش مصنوعی سرعت استنتاج ترنسفورمرها را ۱۰۰ برابر کردیم؟
هافینگ فیس با ترکیب تکنیک های بهینه سازی و کامپایلرهای تخصصی، استنتاج ترنسفورمرها را برای مشتریان API خود ۱۰۰ برابر سریع تر کرد. در این مقاله بررسی می کنیم.