
 پژوهش
هوش مصنوعی و HealthBench: استاندارد جدید ارزیابی مدلهای پزشکی
HealthBench، یک بَنکنشین منظم برای ارزیابی هوش مصنوعی در حوزه سلامت است. با همکاری بیش از ۲۵۰ متخصص پزشکی، این ابزار کیفیت و ایمنی مدلها را در سناریوهای واقعی سنجیده میکند.
 پژوهش
ارتقای ارزیابی هوش مصنوعی عربی: معرفی AraGen و Instruction Following
در این مقاله به بهروزرسانیهای اخیر در Leaderboard عربی میپردازیم؛ معرفی AraGen 03–25، Instruction Following و چگونگی ارزیابی مدلهای زبان عربی با معیارهای IFEval دقیق و کامل توسعه
 پژوهش
هوش مصنوعی در آزمون PaperBench: توانایی بازتولید پژوهشهای پیشرفته
PaperBench، بنچمارکی که توسط OpenAI معرفی شده، توانایی هوش مصنوعیها در بازتولید پژوهشهای پیشرفته را با دقت و جامعگی ارزیابی میکند.
 پژوهش
آیندهساز کدنویسی: لیورورد LiveCodeBench و ارزیابی هوش مصنوعی بر رمز و تلاقی
LiveCodeBench یک بنچمارک نوین برای ارزیابی تولید کد توسط مدلهای هوش مصنوعی است که با استفاده از مسائل واقعی مسابقات برنامهنویسی، ارزیابیهای زمانی و تست خروجی را پوشش میدهد.
 پژوهش
ConTextual: معیاری تازه برای سنجش هوش مصنوعی چندوجهی در صحنههای متنی
آشنایی با ConTextual، معیار جدید Hugging Face برای ارزیابی مدلهای چندوجهی در درک همزمان متن و تصویر؛ گامی به سوی هوش مصنوعی باز و دموکراتیک.
 پژوهش
رهبر جدید ارزیابی هوش مصنوعی کرهای با شفافیت کامل معرفی شد
پروژه Open Ko-LLM با همکاری آپ استیج و هافینگ فیس، اکوسیستم ارزیابی مدلهای زبانی کرهای را متحول کرد؛ رقابت منصفانه و شفافیت در این رهبر تضمین شده است.
 پژوهش
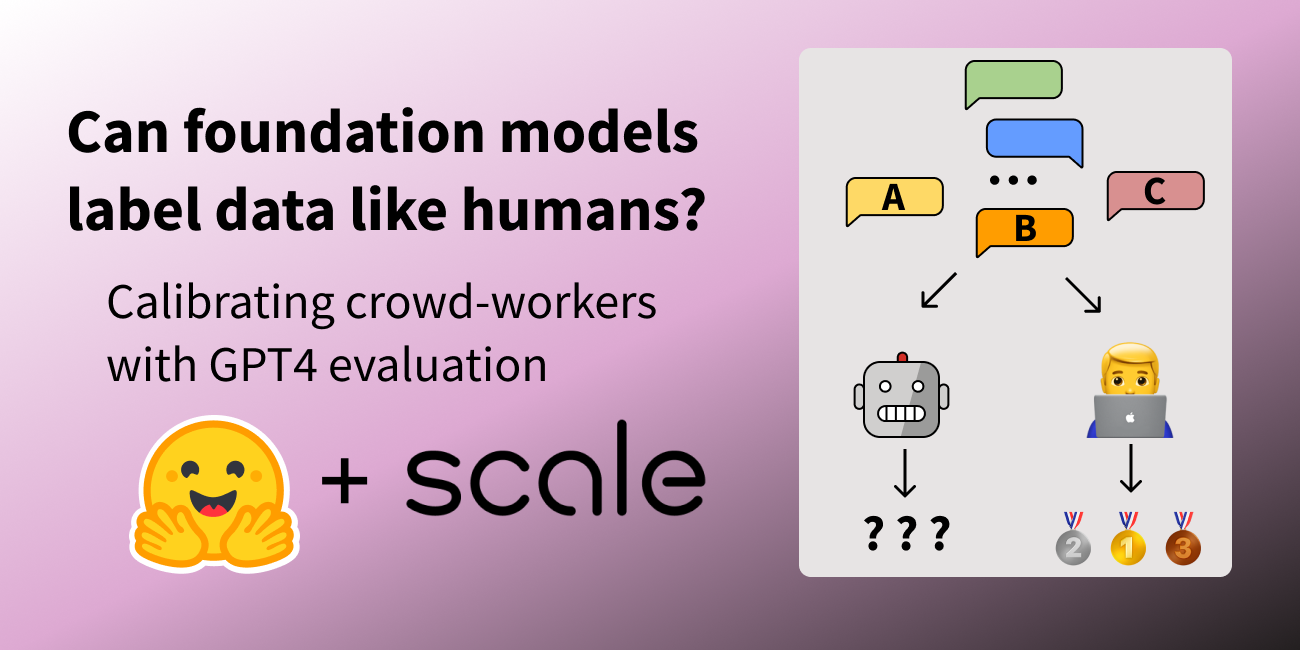
آیا مدلهای بنیادی هوش مصنوعی میتوانند دادهها را مانند انسان برچسبگذاری کنند؟
هوش مصنوعی و برچسبگذاری داده: بررسی میکند که آیا مدلهای بنیادی قادر به تشخیص و اولویتبندی دادهها مانند انسان هستند یا خیر. مقایسه نتایج مدلها با قضاوت انسانی در سنجش کارایی آنها.
 پژوهش
ارزیابی مدلهای زبانی بزرگ آموزشدیده روی کد؛ رویکرد نوین OpenAI
در این مقاله به بررسی روشهای ارزیابی مدلهای زبانی بزرگ متخصص در کدنویسی میپردازیم و معیار HumanEval و اهمیت آن را برای سنجش هوش مصنوعی کدنویس تحلیل میکنیم.
 پژوهش
معیار جدید Procgen؛ سنجش تعمیمپذیری مهارتهای عاملهای هوش مصنوعی
در این مقاله، معیار Procgen Benchmark از OpenAI را بررسی میکنیم؛ ابزاری با ۱۶ محیط رویهای که سرعت یادگیری مهارتهای قابلتعمیم را در عاملهای یادگیری تقویتی میسنجد.