
 پژوهش
برندمارک 3LM: استاندارد نوین هوش مصنوعی عربی در STEM و برنامهنویسی
برندمارک ۳LM، استانداردی جدید برای ارزیابی مدلهای زبانی عربی در حوزههای علمی‑فناوری و برنامهنویسی، با تمرکز بر مسائل تخصصی و کد. در این مقاله به جزئیات روش، مجموعه دادهها و نتایج کلیدی میپردازیم.
 پژوهش
هوش مصنوعی و HealthBench: استاندارد جدید ارزیابی مدلهای پزشکی
HealthBench، یک بَنکنشین منظم برای ارزیابی هوش مصنوعی در حوزه سلامت است. با همکاری بیش از ۲۵۰ متخصص پزشکی، این ابزار کیفیت و ایمنی مدلها را در سناریوهای واقعی سنجیده میکند.
 پژوهش
هوش مصنوعی: HELMET، رویکرد جامع برای ارزیابی مدلهای طویل متن
HELMT، چارچوب ارزیابی نوین برای مدلهای زبان با طول متن بلند، به صورت متن باز و تحقیقاتی، نمونههای کاربردی و مزایای آن در دنیای هوش مصنوعی را میپذیرد.
 پژوهش
ارتقای ارزیابی هوش مصنوعی عربی: معرفی AraGen و Instruction Following
در این مقاله به بهروزرسانیهای اخیر در Leaderboard عربی میپردازیم؛ معرفی AraGen 03–25، Instruction Following و چگونگی ارزیابی مدلهای زبان عربی با معیارهای IFEval دقیق و کامل توسعه
 مدلها
هوش مصنوعی عربی؛ سکوی برتری مدلهای زبانی نسخه دوم منتشر شد
نسخه دوم سکوی برتری مدلهای زبانی عربی (Open Arabic LLM Leaderboard 2) منتشر شد تا ارزیابی مدلهای هوش مصنوعی را شفافتر و یکپارچهتر کند.
 پژوهش
هوش مصنوعی: چگونه تولید خروجی ساختاریافته انتظارهای پایدار را برانگیزد
تجربههای جدید حاکی از حساسیت ارزیابی مدلهای زبانی به فرمتهای مدخل است. روش ساختاردهی خروجی در Hugging Face، ثبات را بهبود میبخشد.
 اخبار
جدول تازه سنجش هوش مصنوعی در پزشکی؛ ارزیابی مدلهای زبانی بالینی
هوگینگ فیس با انتشار جدول ردهبندی باز Medical-LLM، معیاری تازه برای ارزیابی مدلهای زبانی در حوزه سلامت ارائه کرده تا عملکرد هوش مصنوعی در کارهای بالینی شفافتر شود.
 پژوهش
ConTextual: معیاری تازه برای سنجش هوش مصنوعی چندوجهی در صحنههای متنی
آشنایی با ConTextual، معیار جدید Hugging Face برای ارزیابی مدلهای چندوجهی در درک همزمان متن و تصویر؛ گامی به سوی هوش مصنوعی باز و دموکراتیک.
 پژوهش
رهبر جدید ارزیابی هوش مصنوعی کرهای با شفافیت کامل معرفی شد
پروژه Open Ko-LLM با همکاری آپ استیج و هافینگ فیس، اکوسیستم ارزیابی مدلهای زبانی کرهای را متحول کرد؛ رقابت منصفانه و شفافیت در این رهبر تضمین شده است.
 پژوهش
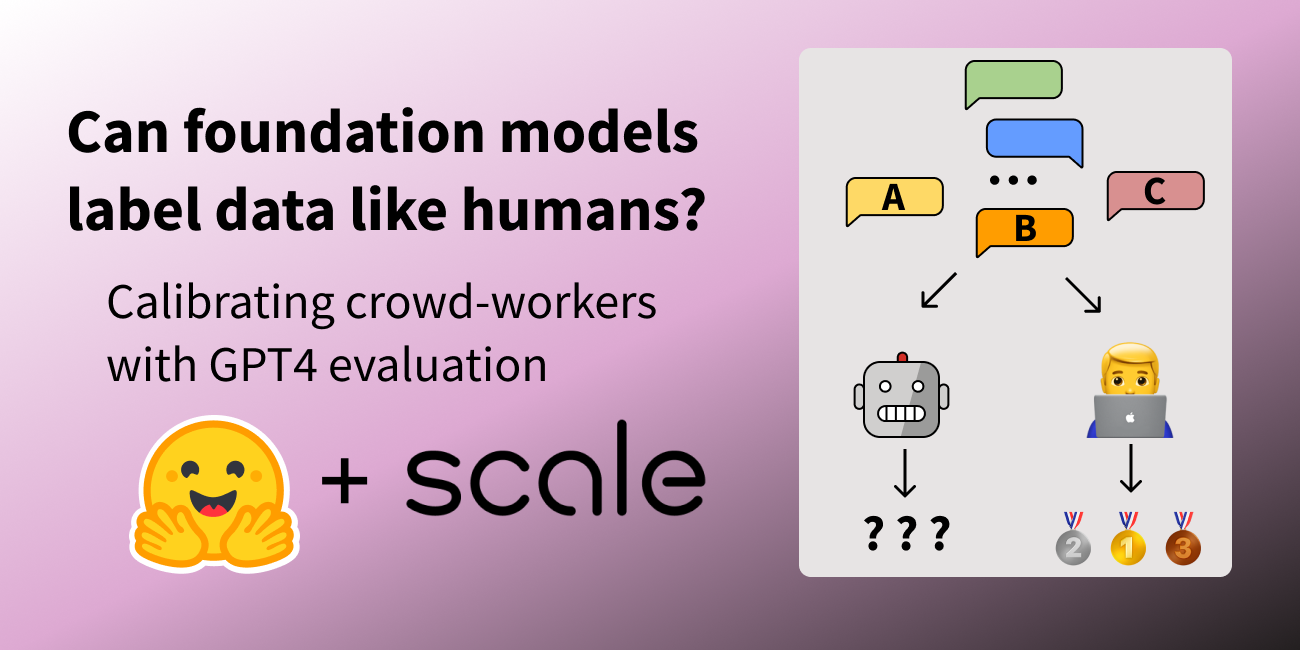
آیا مدلهای بنیادی هوش مصنوعی میتوانند دادهها را مانند انسان برچسبگذاری کنند؟
هوش مصنوعی و برچسبگذاری داده: بررسی میکند که آیا مدلهای بنیادی قادر به تشخیص و اولویتبندی دادهها مانند انسان هستند یا خیر. مقایسه نتایج مدلها با قضاوت انسانی در سنجش کارایی آنها.