
 پژوهش
هوش مصنوعی Ettin Suite: مدلهای Encoder-Decoder در سطح جدید
Ettin Suite، یک مجموعه بازمتداول جدید، با روشهای مدرن آموزش، Encoder-Only ModernBERT و Decoder-Only مدلی برتر از Llama 3.2 و SmolLM2 ارائه میدهد؛ این پیشرفت، احتمالا مسیر هوش مصنوعی را تغییر خواهد داد.
 مدلها
هوش مصنوعی و گریدیو MCP: گام جدید برای ارتقاء مدلهای زبان - تبدیل مدلهای زبانی
با گریدیو MCP Servers، مدلهای زبانی خود را به راحتی با ابزارهای پیشرفته مانند پردازش تصویر، مرور وب و مدیریت ایمیلها تجهیز کنید؛ روشهای ساده، امن و مقیاسپذیر در قالب سرویسهای ابری.
 پژوهش
هوش مصنوعی: رقابت E2LM 2025 – ارزیابی زودهنگام مدلهای زبانی
در قالب جدید پیشآموزش مدلهای زبانی، رقابت E2LM 2025 مهندسان را میطلبد؛ نتایج در NeurIPS 2025 اعلام خواهد شد با سه ماه برای ثبتنام
 آموزش
به سوی درک و جلوگیری از تعمیم نادرست
ما بررسی میکنیم که چگونه آموزش بر اساس پاسخهای نادرست میتواند باعث ناهماهنگی گستردهتر در مدلهای زبانی شود و یک ویژگی داخلی را که این رفتار را هدایت میکن
 سختافزار
هوش مصنوعی در دستهی Groq: پیوستن به Hugging Face و سرعت بینظیر
Groq به تازگی به عنوان یک ارائهدهندهی استنتاج در Hugging Face Hub معرفی شد؛ تکنولوژی LPU™ آن، سرعت بیسابقهای را برای مدلهای زبانی سنگین فراهم میکند. این پیشرفت در حوزهی سرورلس و هوش مصنوعی چگونگی کارکرد آن چیست؟
 پژوهش
هوش مصنوعی در دسترس همه: همکاری NVIDIA و Hugging Face معرفی سرویس خوشهسازی آموزش
در روزگارد GTC پاریس، همکاری جدید هگینگ فیس و NVIDIA چرخاندن دسترسی به خوشههای گرافیک بالا را برای مراکز پژوهشی فراهم میکند. سرویس Training Cluster as a Service امکان آموزش مدلهای بنیادی در حوزههای مختلف را به همه میدهد.
 پژوهش
همکاری هوش مصنوعی: اتصال هنجینگ فیس با کگل برای دسترسی سریع به مدلها
کگل و هنجینگ فیس در گام جدیدی پیشقدم شدند؛ با ادغام مستقیم مدلها، دسترسی راحتتر و اجرای سریعتر را برای پژوهشگران داده ارائه میدهند.
 پژوهش
هوش مصنوعی بهدنبال دلباخش: تفسیری عمیق بر دیدگاه OpenAI
OpenAI گزارش جدیدی را درباره رفتار شایسته مدلهای زبانی منتشر کرد. این مقاله، اختلالات گذشته، نتایج تحقیق و راهکارهای آینده را معرفی میکند.
 پژوهش
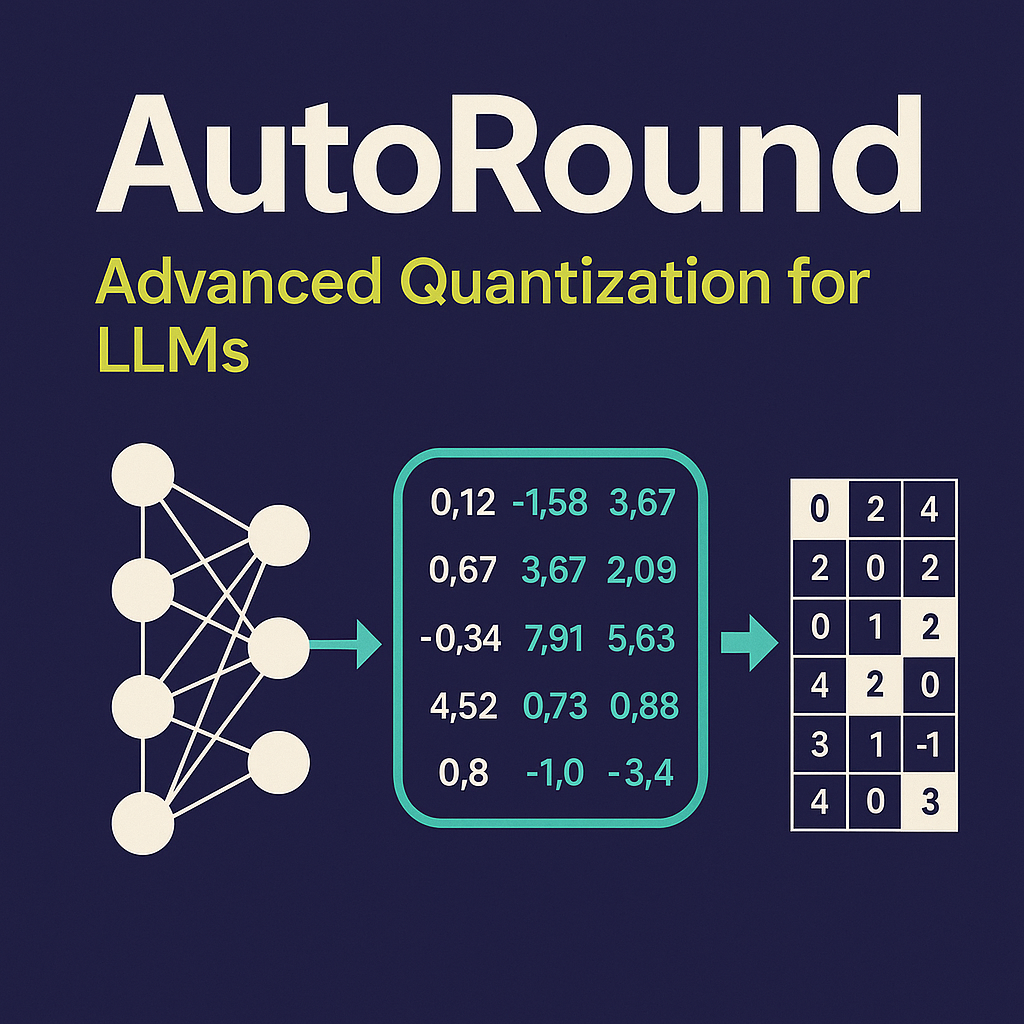
هوش مصنوعی: AutoRound شرکت اینتل برای کمینهسازی مدلهای LLM و VLM
AutoRound از اینتل، یک ابزار کوانتایزیشن وزن-فقط برای LLMs و VLMs است که با دقت بالا در بیتهای 2 تا 8، حجم مدل را تا ۳۰٪ کاهش میدهد.
 پژوهش
هوش مصنوعی و Prefill - راهکارهای بهینهسازی پردازش موازی در LLM
در این گزارش به بررسی استراتژیهای Prefill و Decode برای پردازش موازی در مدلهای زبانی بزرگ میپردازیم، تمرکز بر بهینهسازی تاخیر، Throughput و مصرف GPU.