
 سختافزار
AMD EPYC نسل پنجم: دو برابر سرعت LLM و شتاب AI با Zen5
AMD نسل پنجم EPYC را به بازار معرفی کرد؛ با معماری Zen5 و حداکثر 192 هسته، سرعت اجرای مدلهای زبانی دو برابر میشود و شتاب AI در سرورها افزایش مییابد.
 پژوهش
هوش مصنوعی در زبان چک: BenCzechMark و آزمون دقیق مدلهای LLM
بنچکمارک اولین مجموعه ارزیابی جامع برای مدلهای بزرگ زبان (LLM) در زبان چک را معرفی میکند. با ۵۰ کار و ۹ حوزه، عملکرد زبانپردازی را اینچنین بررسی میکند.
 کسبوکار
تنظیم دقیق GPT‑4o: راهکارهای کلیدی برای کسبوکارهای هوش مصنوعی
در وبینار جدید OpenAI، نحوه تنظیم دقیق مدل GPT‑4o برای بهینهسازی عملکرد در سناریوهای کسبوکار و فرآیند ساخت راهنماهای سفارشی بررسی شد.
 پژوهش
هوش مصنوعی و آزمایش ناکام «Infini‑Attention»؛ چرا هنوز تلاش کنیم؟
استخراج و آزمایش مدل Infini‑Attention نشان داد که فشردهسازی حافظه مدل در طول زمینه طولانی باعث کاهش عملکرد میشود؛ این مقاله به بررسی دلایل این شکست و نگاهی به راههای جایگزین میپردازد.
 مدلها
کوانتایز دیفیوژن ترنسفورمر با Quanto: کاهش مصرف حافظه در هوش مصنوعی
با معرفی ابزارهای Quanto و Diffusers، اجرا کردن مدلهای سنگین تولید تصویر با هوش مصنوعی بر روی سختافزارهای محدودتر بدون افت عملکرد محسوس اکنون امکانپذیر است.
 مدلها
هوش مصنوعی با GPT‑4o mini: کارایی بالا در هزینه کمتر
OpenAI با معرفی GPT‑4o mini، نسخهای کمهزینه و با قدرت مشابه مدلهای پیشین ارائه داد. این مدل امکان پردازش هوشمند را در هزینهای گزافکاهش میدهد.
 اخبار
هوش مصنوعی بهتر: نقش کلیدی کیفیت داده در ساخت مدلهای پیشرفته
نوشتهای درباره اهمیت کیفیت داده در توسعه هوش مصنوعی: تأثیر بر عملکرد مدل، نمایندگی، حاکمیت، تعمیم و قابلیتتکرار علمی.
 پژوهش
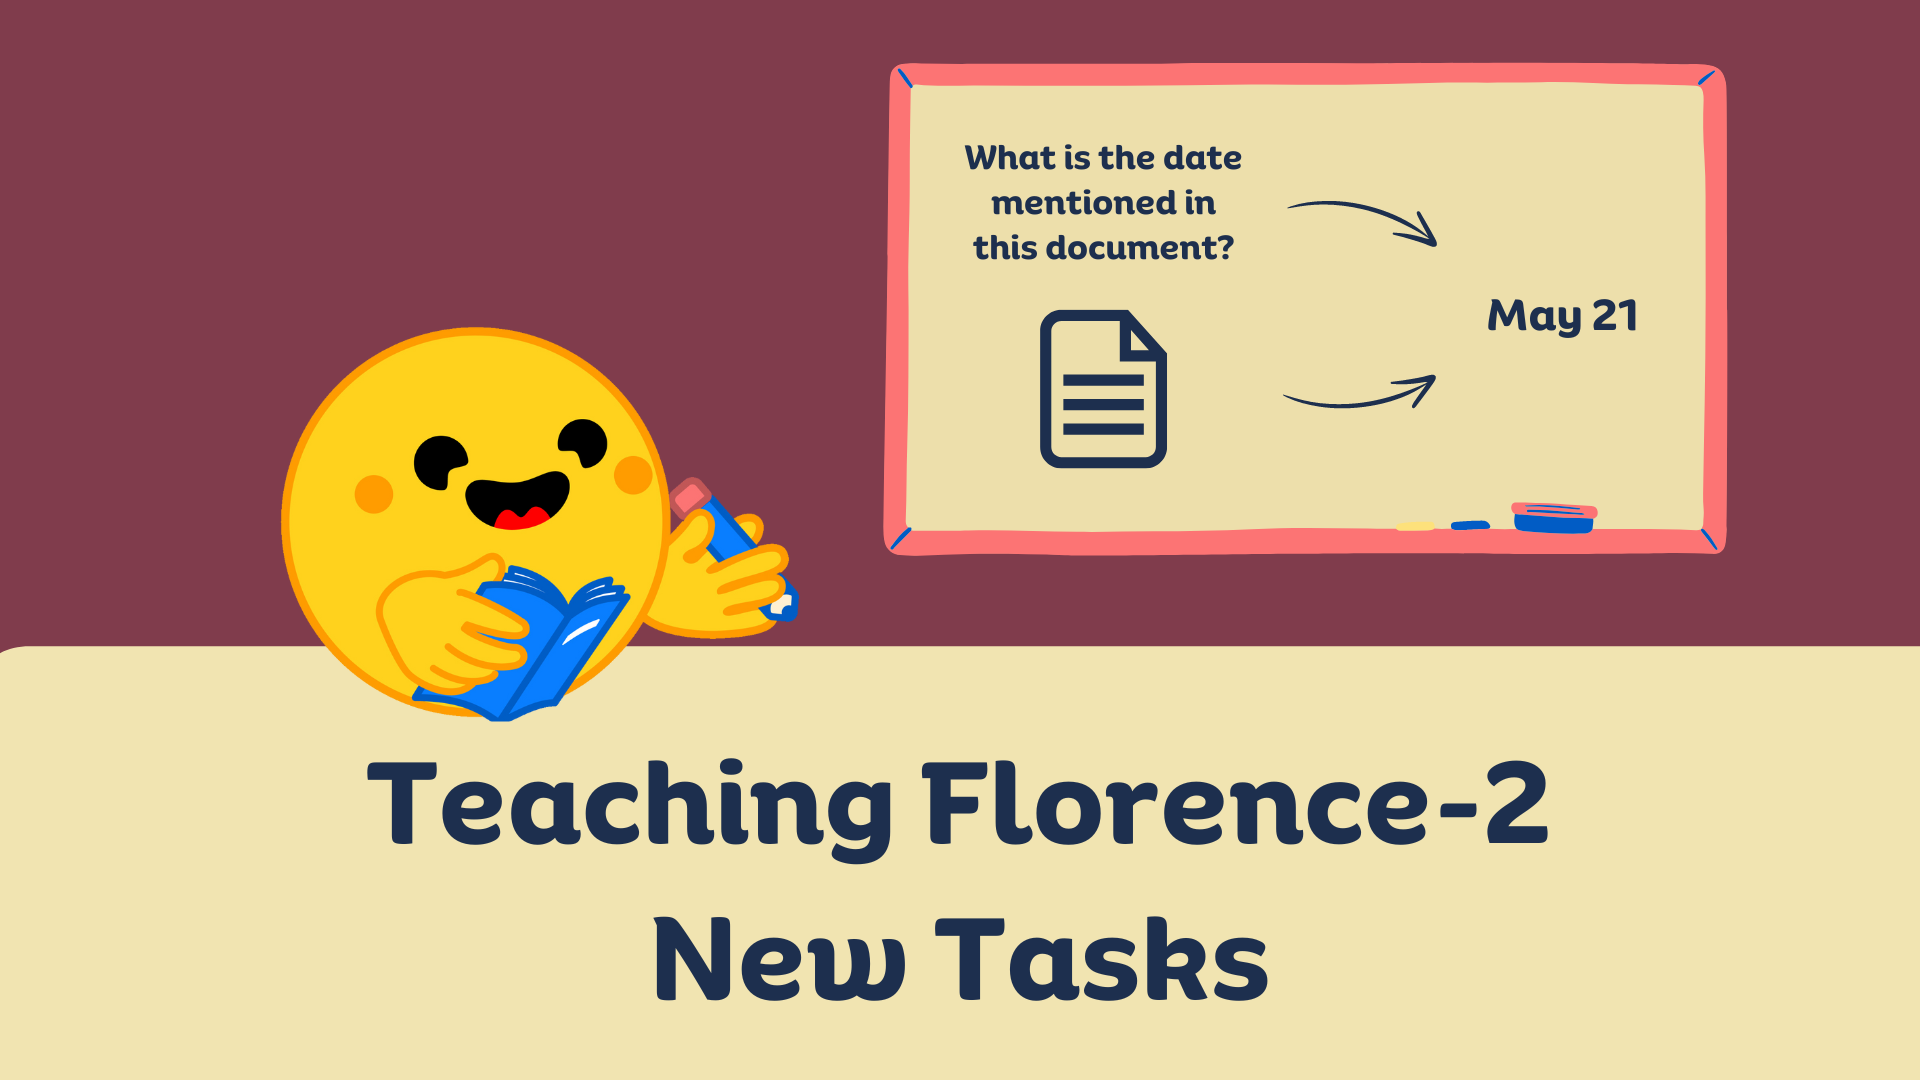
هوش مصنوعی در سرپرستی Microsoft: Fine-tuning Florence‑2 برای پاسخگویی به اسناد
مدل Florence‑2 شرکت مایکروسافت با عملکرد بالا و اندازه کوچک، امکان fine‑tuning برای DocVQA را فراهم کرده؛ این مقاله مراحل و نتایج این فرآیند را توضیح میدهد.
 پژوهش
هوش مصنوعی با رویکرد جامع، حذف محتواهای نامطلوب با دقت واقعی
OpenAI با رویکرد جامع، برای شناسایی محتوای نامطلوب طراحی کرده یک سامانه طبقهبندی زبان طبیعی که در دنیای واقعی عملکرد و کارایی بالایی دارد.
 پژوهش
هوش مصنوعی و OpenAI: استقبال از CFO سارا فریر و CPO کِیمن ویل
OpenAI تازگی سارا فریر را CFO و کاِیمن ویل را CPO معرفی کرده؛ این اقدام جهت تقویت رهبری مالی و استراتژیک شرکت و بهبود عملکرد اوپنای برای رقابت است.