Diffusers 0.3 چیست و چه ویژگیهای نوآورانهای دارد؟
کتابخانه Diffusers که در ابتدا در اوایل سال ۲۰۲۲ منتشر شد، یک چارچوب متنباز برای مدلهای انتشار (Diffusion) است. نسخهٔ ۰.۳ با افزودن قابلیتهای پیشرفته و بهینهسازیهای گرافیکی، به توسعهدهندگان امکان میدهد تا از مدلهای پیشرفتهتر بهصورت ساده و منظم استفاده کنند.
تولید تصویر از تصویر (Image‑to‑Image) و بهینهسازیهای جدید
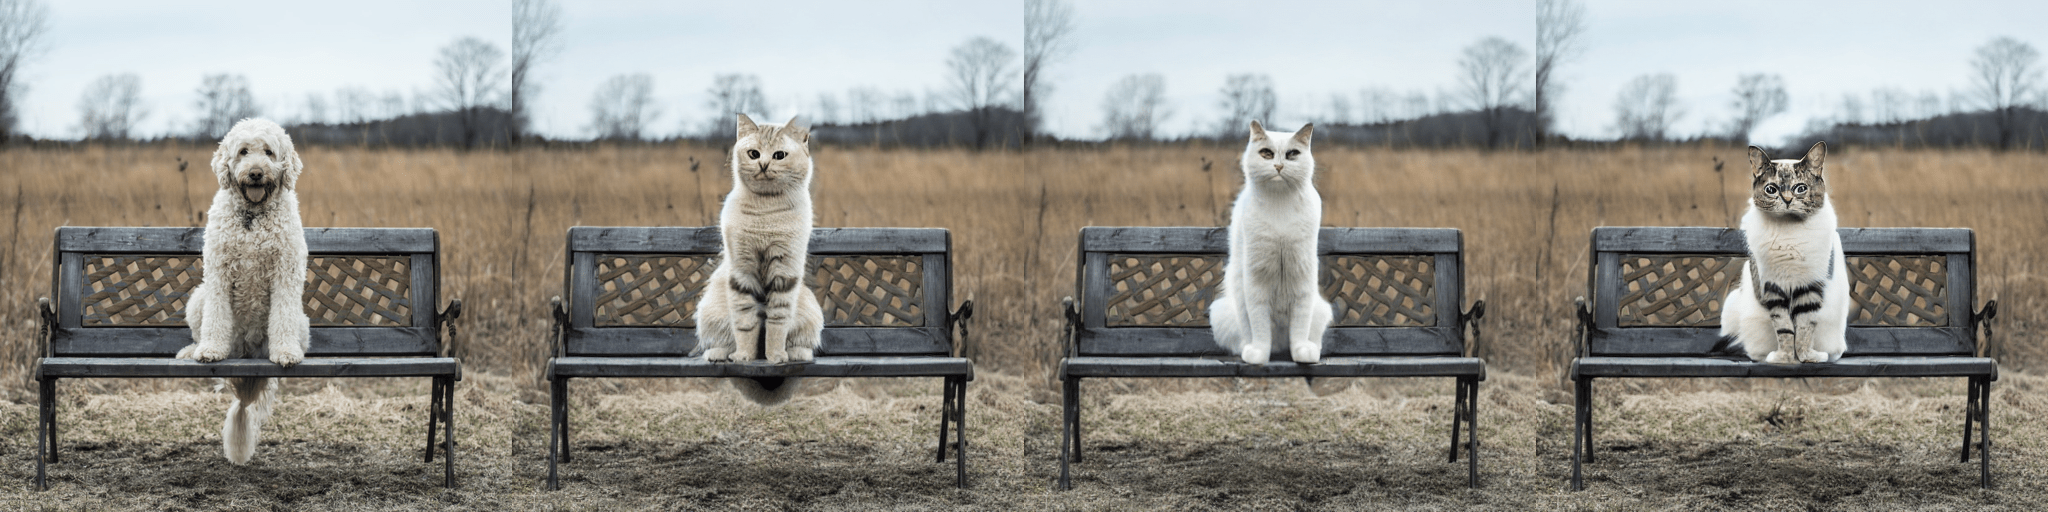
یکی از ویژگیهای برجسته این نسخه، امکان تولید تصویر بر اساس تصویر ورودی و دستور العمل متنی است. این قابلیت بهصورت کامل مقیاسپذیر است، بهطوریکه میتوانید با اصلاح جزئیات و سبکهای مختلف، تصاویر بهسوی سلیقهتان را تغییر دهید.
علاوه بر آن، قابلیتهای دیگری همچون Inpainting، Textual Inversion و غیره میتوانند بهسختترین پروژههای تغییر رنگ و تغییر شکل تصاویر پاسخ دهند.
چگونه میتوان از امکانات جدید در پروژههای خود استفاده کرد؟
برای استفاده از این امکانات، ابتدا کتابخانه را با دستور pip install diffusers نصب کرده و سپس بهترین مدل مورد نیاز خود را بارگذاری کنید. نمونه کد ساده در زیر آمده است:
- Image‑to‑Image Pipeline: from diffusers import StableDiffusionImg2Img
- Textual Inversion: pipeline = DiffusionPipeline.from_pretrained("stabilityai/stable-diffusion-2")
- Inpainting: pipeline_inpaint = DiffusionPipeline.from_pretrained("runwayml/inpainting")
بهعنوان نکتهٔ مهم، اطمینان حاصل کنید که کارت گرافیک شما، بهویژه GPUهای کوچک، از بهینهسازیهای جدید پشتیبانی میکنند. برای پردازنهای کوچک، معمولاً توصیه میشود از diffusers.optimize_for_small_gpu() استفاده کنید.
در نهایت، جامعهٔ Hugging Face امکاناتی چون مستندات جامع و Spaces برای نمایش و آزمایش مدلهای منتشر شده فراهم کرده است. این امر کاربرانی که تازه وارد حوزهٔ هوش مصنوعی میشوند، میتواند تجربهٔ یادگیری شیرینتری باشد.
پرسشهای پرتکرار
کتابخانه Diffusers چیست؟
کتابخانه Diffusers یک ابزار متنباز است که به توسعهدهندگان امکان استفاده از مدلهای انتشار (diffusion) در حوزههای متنوعی، از جمله تولید تصویر و تغییر رنگ، را میدهد.
چگونه میتوان Pipeline تصویر به تصویر را فعال کرد؟
در کتابخانه Diffusers، برای فعالسازی Image‑to‑Image Pipeline کافی است مدل را بارگذاری کرده و تابع StableDiffusionImg2Img را فراخوانی کنید؛ سپس تصویر ورودی و prompt را وارد کنید.