
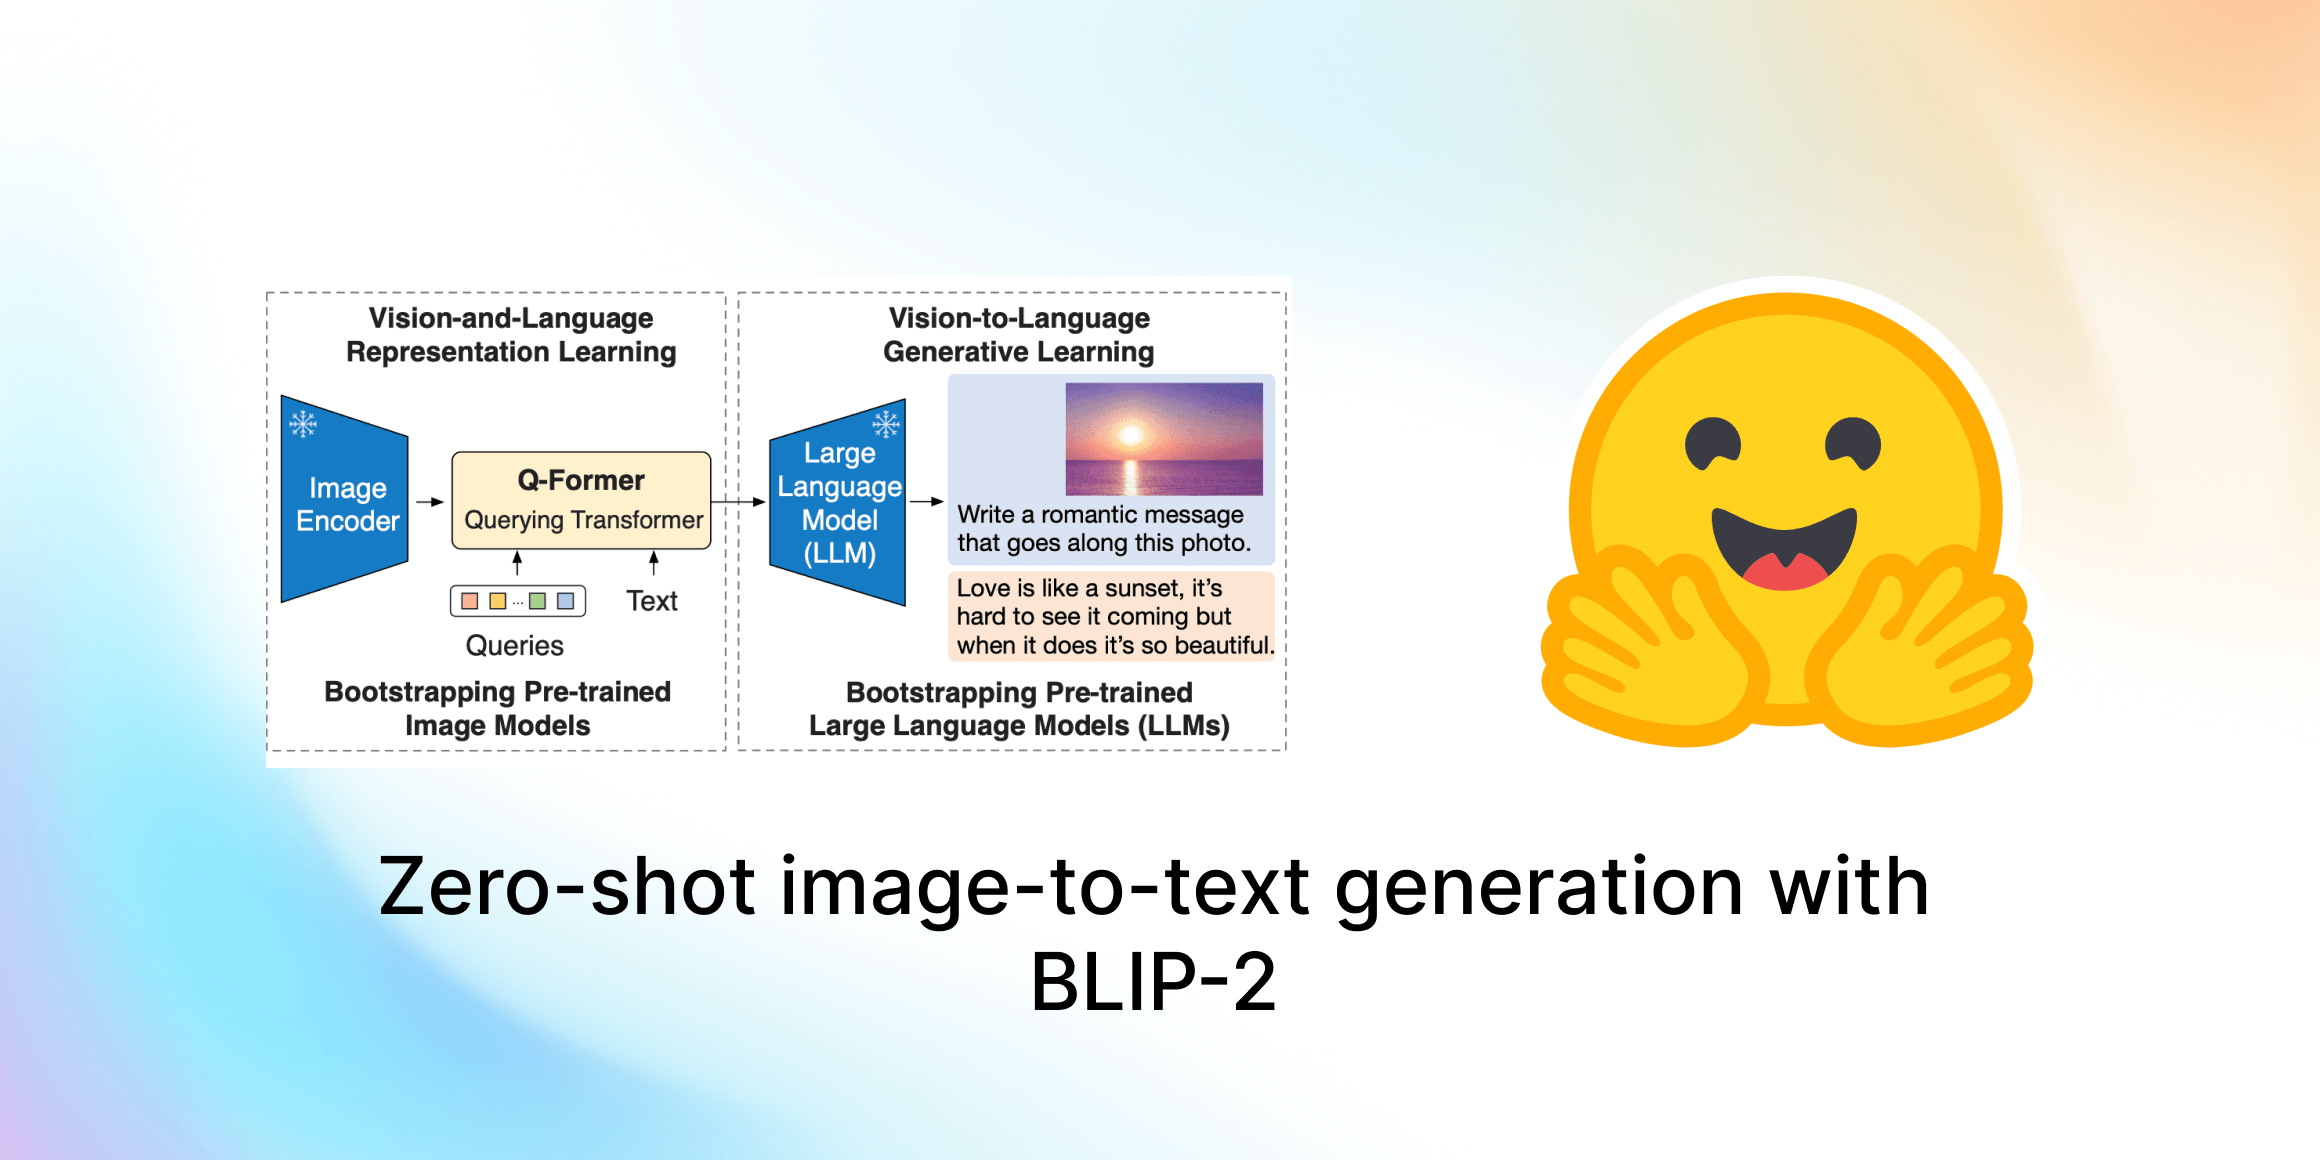
معرفی BLIP‑2
توسعه مبهمی میان یادگیری ماشین و بینایی کامپیوتری به آن دسته از مدلهای آماری میرسد که میتوانند به صورت چندرسانهای تصویر و متن را درک کنند. BLIP‑2 در این حوزه یک قدم بزرگ به جلو برداشته و بهعنوان یک مدل Zero‑shot تصویر‑به‑متن معرفی شد.
انواع کاربردها
این مدل توانایی انجام چندین کار را دارد، از جمله:
- کپشنسازی تصاویر برای دسترسی افراد ناتوان بینایی
- پرسش‑جواب تصویری برای بهبود تعاملات یادگیری و پشتیبانی مشتری
- جستجوی چندرسانهای و فهرستسازی خودکار محتوا در شبکههای بزرگ
چگونه با Hugging Face استفاده کنیم
پیکرهبندی BLIP‑2 در Hugging Face Transformers آمادهی استفاده میباشد. با فراخوانی توابع ساده، میتوانید شروع به تولید کپشن کنید و در برنامههای خود ادغام کنید.
بهعنوان مثال کدی که در محیطهای یادگیری محبوب پایتون قابل اجرا است:
from transformers import BlipProcessor, BlipForConditionalGeneration processor = BlipProcessor.from_pretrained("Salesforce/blip2-opt-2.7b") model = BlipForConditionalGeneration.from_pretrained("Salesforce/blip2-opt-2.7b") image = Image.open("path_to_image.jpg") inputs = processor(image, return_tensors="pt") generated_ids = model.generate(**inputs) caption = processor.decode(generated_ids[0], skip_special_tokens=True) print(caption)
پرسشهای پرتکرار
Zero‑shot چیست و چرا برای BLIP‑2 مهم است؟
Zero‑shot به معنای توانایی مدل برای انجام وظایف جدید بدون آموزش پیشنیاز است. BLIP‑2 با استفاده از دادههای بزرگ و معماری پیشرفته قادر است به طور مستقیم تصاویر را به متن تبدیل کند، بدون نیاز به تنظیم خاص روی کارهای مورد نظر.
چگونه میتوان BLIP‑2 را در پروژههای خود به کار برد؟
با نصب کتابخانهی Hugging Face Transformers کافی است مدل و پردازنده مناسب را بارگذاری کنید و تصاویر را به عنوان ورودی ارسال کنید. کدهای نمونه در مستنداتی در سایت Hugging Face موجود است که میتوانید در پروژههای تحقیقاتی یا تولیدی خود اعمال کنید.


