چالشهای مدیریت مدلهای متعدد
سازمانهای امروز در حوزه هوش مصنوعی با رشد روز افزون مدلهای خاص و fine‑tuned روبهرو هستند. هر یک از این مدلها نیازمند درایور، ذخیرهسازی و ردیابی جداگانه است؛ همین امر باعث افزایش هزینه و پیچیدگی میشود.
مفهوم Multi-LoRA و چگونگی عملکرد آن
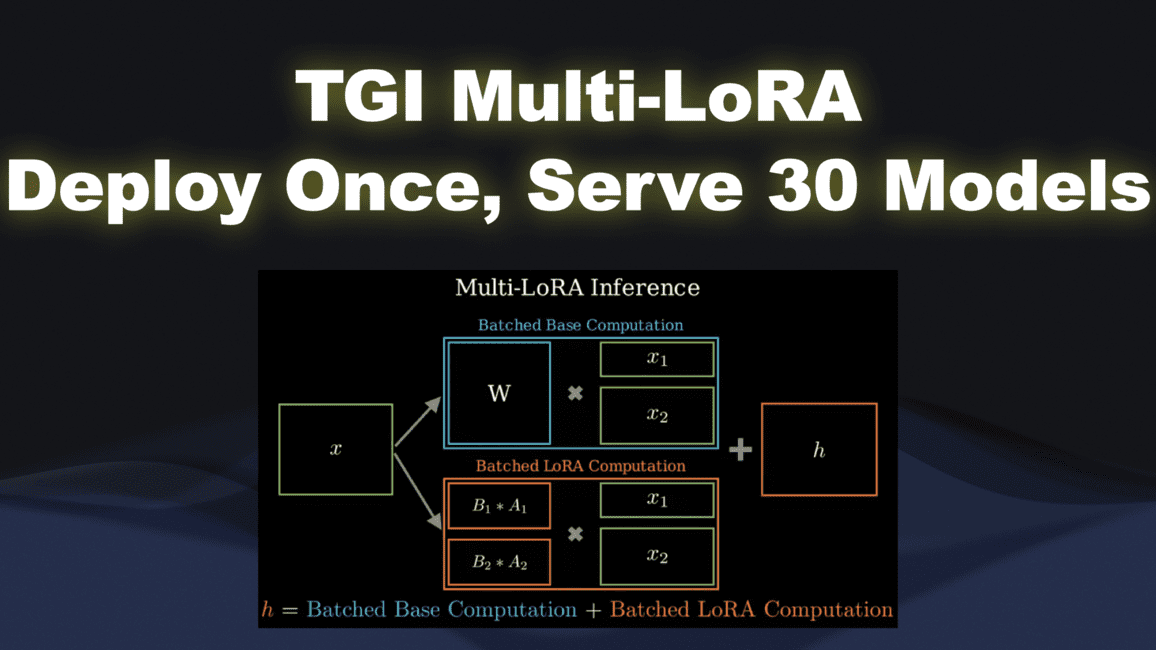
Multi‑LoRA ترکیبی از تکنیک LoRA (Low‑Rank Adaptation) و زیرساخت TGI (Text Generation Inference) است که بهویژه برای بهینهسازی مصرف حافظه و افزایش سرعت طراحی شده است. با استفاده از LoRA، تنها پارامترهای محوشده بر روی یک مدل پایه افزوده میشود، در حالی که مدل پایه حفظ میشود.
مزایای اصلی و اقتصادی
- پایینترین هزینه برای دسترسی به چندین مدل از طریق یک نقطهٔ دیپلوی.
- کاهش زمان deployment تا چند ثانیه برای مدلهای تازهافزوده.
- پشتیبانی از اکثر زبانهای برنامهنویسی و APIهای RESTful.
- قابلیت مقیاسپذیری افقی برای استفاده در محیطهای سازمانی.
نحوهای برای شروع با TGI Multi-LoRA
برای استفاده از سرویس کافی است یک EndPoint در TGI ایجاد کرده، LoRAهای خود را بارگذاری و به راحتی با آدرس URL مرتبط میتوانید بهصورت چند مورد در کنار هم دسترسی داشته باشید. تنظیمات مصرف منابع و زمانبندی نیز قابل تنظیم است.
نتیجهگیری
استفاده از TGI Multi‑LoRA نه تنها عملکرد مدل را بهبود میبخشد بلکه فرآیند زیرساختی را بهصورت قابل کنترل و مقرون به صرفه میکند. برای کسبوکارهایی که به چندین مدل خاص نیاز دارند، این ابزار تبدیل به راهکار استانداردی برای اقتصاد مدلهای AI و بهرهوری بالا میشود.
پرسشهای پرتکرار
Multi-LoRA چطور بهخوبی با مدلهای مختلف کار میکند؟
تعریف LoRA برای هر مدل خاص، فقط سطوح اضافی را به مدل پایه اضافه میکند؛ به این ترتیب میتوان چندین مدل بر پایه همان مدل پایه را با استفاده از پارامترهای متفاوت اجرا کرد.
آیا برای استفاده از TGI Multi-LoRA نیاز به دانش فنی پیشرفته وجود دارد؟
خیر، Hugging Face یک رابط کاربری گرافیکی و مستندات کاملی در اختیار برنامهنویسان و مدیران فراهم کرده است؛ حتی بدون تجربه قبلی میتوانید یک EndPoint بسازید و LoRAهای خود را بارگذاری کنید.