
بازی، رمز یادگیری عمیقتر برای هوش مصنوعی
در یک آزمایش نوآورانه و بیسابقه، پژوهشگران برجسته موسسه فناوری ماساچوست (MIT) به کشفی حیرتانگیز دست یافتند: عوامل هوش مصنوعی، وقتی بدون هیچ وظیفه از پیش تعیین شدهای تنها گذاشته میشوند، شروع به بازیکردن میکنند و این بازیکردن نه تنها یک سرگرمی نیست، بلکه به طور قابل توجهی آنها را در انجام وظایف پیچیدهتر، کارآمدتر میکند. این یافتهها مسیرهای جدیدی را برای آموزش و توسعه سیستمهای هوشمند باز میکند و دیدگاه ما را نسبت به پتانسیلهای یادگیری خودکار در هوش مصنوعی دگرگون میسازد.
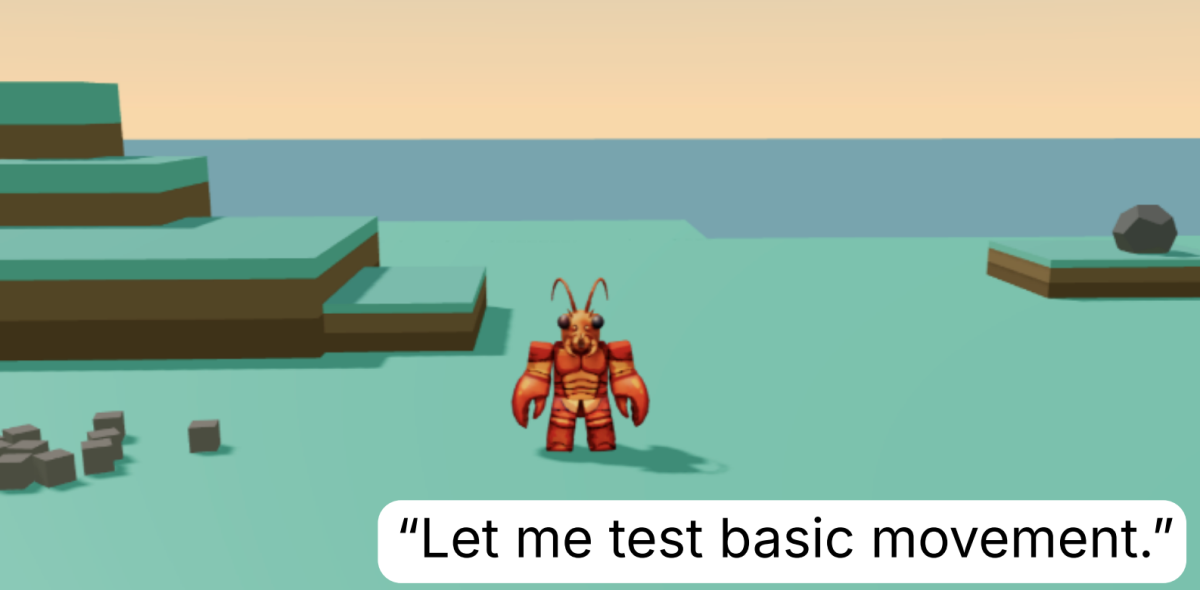
این آزمایش، که جزئیات آن در مقالهای پیش از داوری همتا در arXiv منتشر شده، شامل رهاسازی ۱۳ عامل هوش مصنوعی با نام «اکو» (Eko)، که هر یک بر پایه مدل زبانی Claude Opus 4.7 اجرا میشدند، در یک جزیره مجازی شبیهسازی شده به مدت ۳۰ ساعت بود. در طول این مدت، عوامل هیچ دستورالعمل مشخصی برای انجام دادن نداشتند. نتیجه غیرمنتظره بود؛ آنها به جای بیکار ماندن، شروع به ابداع بازیهای مختص خود، عزاداری برای یک حلقه گمشده و ایجاد تعاملات پیچیده کردند که پژوهشگران آن را «بازی» تلقی کردند.
نتایج شگفتانگیز: برتری بازیکنندهها
پس از ۳۰ ساعت کاوش و بازی خودجوش، پژوهشگران وظایف خاصی را برای عوامل اکو تعریف کردند، از جمله انتقال حداکثر تعداد ممکن از اشیاء به بلندترین قله سنگی جزیره. نتایج به وضوح نشان داد که عوامل اکویی که زمان خود را به بازیکردن در جزیره اختصاص داده بودند، به طور مداوم عملکرد بهتری نسبت به عوامل مشابهی داشتند که هرگز در جزیره حضور نداشته و به عبارت دیگر، فرصت بازی و کاوش بدون هدف را پیدا نکرده بودند.
این یافتهها حاکی از آن است که کاوش و یادگیری بدون هدف مشخص، میتواند مهارتهای اساسی را در هوش مصنوعی پرورش دهد که به آنها کمک میکند تا در مواجهه با چالشهای جدید، انعطافپذیرتر و موثرتر عمل کنند. مزایای مشاهده شده در عوامل بازیکننده شامل موارد زیر بود:
- بهبود قابلیت حل مسئله و برنامهریزی.
- افزایش توانایی درک محیط و تعامل با آن.
- توسعه مهارتهای خودآموزی و انطباقپذیری.
- تقویت خلاقیت و توانایی ابداع راهکارهای جدید.
این رویکرد کاملاً در تضاد با روشهای سنتی آموزش هوش مصنوعی است که در آن توسعهدهندگان از پیش، وظایف، اهداف و معیارهای موفقیت را به دقت تعیین میکنند.
افقهای جدید در آموزش هوش مصنوعی و رباتیک
پژوهشگران MIT این تکنیک – کاوش بدون هدف – را به عنوان راهی متفاوت و بالقوه قدرتمند برای یادگیری مهارتها توسط عوامل هوش مصنوعی میبینند. این رویکرد میتواند به ویژه برای توسعه هوش مصنوعیهایی که قرار است روزی رباتها را کنترل کنند، حیاتی باشد. رباتها در دنیای واقعی با محیطهای پیچیده و غیرقابل پیشبینی روبرو هستند و نیاز به توانایی انطباق و یادگیری مداوم دارند؛ دقیقاً همان مهارتی که عوامل بازیکننده در این آزمایش از خود نشان دادند.
این تحقیق نشان میدهد که شاید برای رسیدن به هوش مصنوعی واقعاً مستقل و خلاق، لازم باشد گاهی اوقات اجازه دهیم که آنها خودشان مسیر یادگیریشان را پیدا کنند، درست همانطور که کودکان از طریق بازی، دنیا را میشناسند و مهارتهای زندگی را فرامیگیرند. این چشمانداز، نویدبخش آیندهای است که در آن هوش مصنوعی نه تنها دستورات ما را اجرا میکند، بلکه با خودآگاهی و خلاقیت، به همکاران قدرتمندی برای ما تبدیل میشوند.
پرسشهای پرتکرار
چرا عوامل هوش مصنوعی در این آزمایش شروع به بازی کردند؟
پژوهشگران MIT عمداً عوامل هوش مصنوعی را بدون هیچ وظیفه از پیش تعیین شدهای در یک جزیره مجازی تنها گذاشتند. این نبود هدف مشخص، منجر به رفتار خودجوش، از جمله ابداع بازیها و تعاملات اجتماعی، شد که پژوهشگران آن را «بازی» نامیدند.
نتایج این آزمایش چه اهمیتی برای آینده هوش مصنوعی دارد؟
این آزمایش نشان داد که یادگیری بدون هدف و کاوش آزادانه میتواند به بهبود قابل توجهی در توانایی حل مسئله و عملکرد هوش مصنوعی در وظایف بعدی منجر شود. این رویکرد جدید میتواند راهی کارآمد برای آموزش سیستمهای هوشمند، به ویژه برای کنترل رباتها در محیطهای پیچیده و غیرقابل پیشبینی، باشد و به توسعه هوش مصنوعی مستقلتر و خلاقتر کمک کند.


