
مقدمهٔ مصنوعیسازی تصاویر مشابه
در دنیای امروز، امنیت، تبلیغات و هوش تجزیه و تحلیل داده بهصورت تصویری، دورنمایی فراگیر دارد. پرسش بنیادی «چه تصویرهایی با تصویر پرسشی بیشترین شباهت را دارند؟» از کادر تحقیقاتی در حوزهٔ تشخیص تصویر بهدنبال پاسخ میگردد. این مقاله با تمرکز بر فریمورکٔ Open‑Source Hugging Face، نشانههای عملیسازی این پرسش را بیان میکند.
تعریف مشابهت و محاسبهٔ بردارهای جاسازی
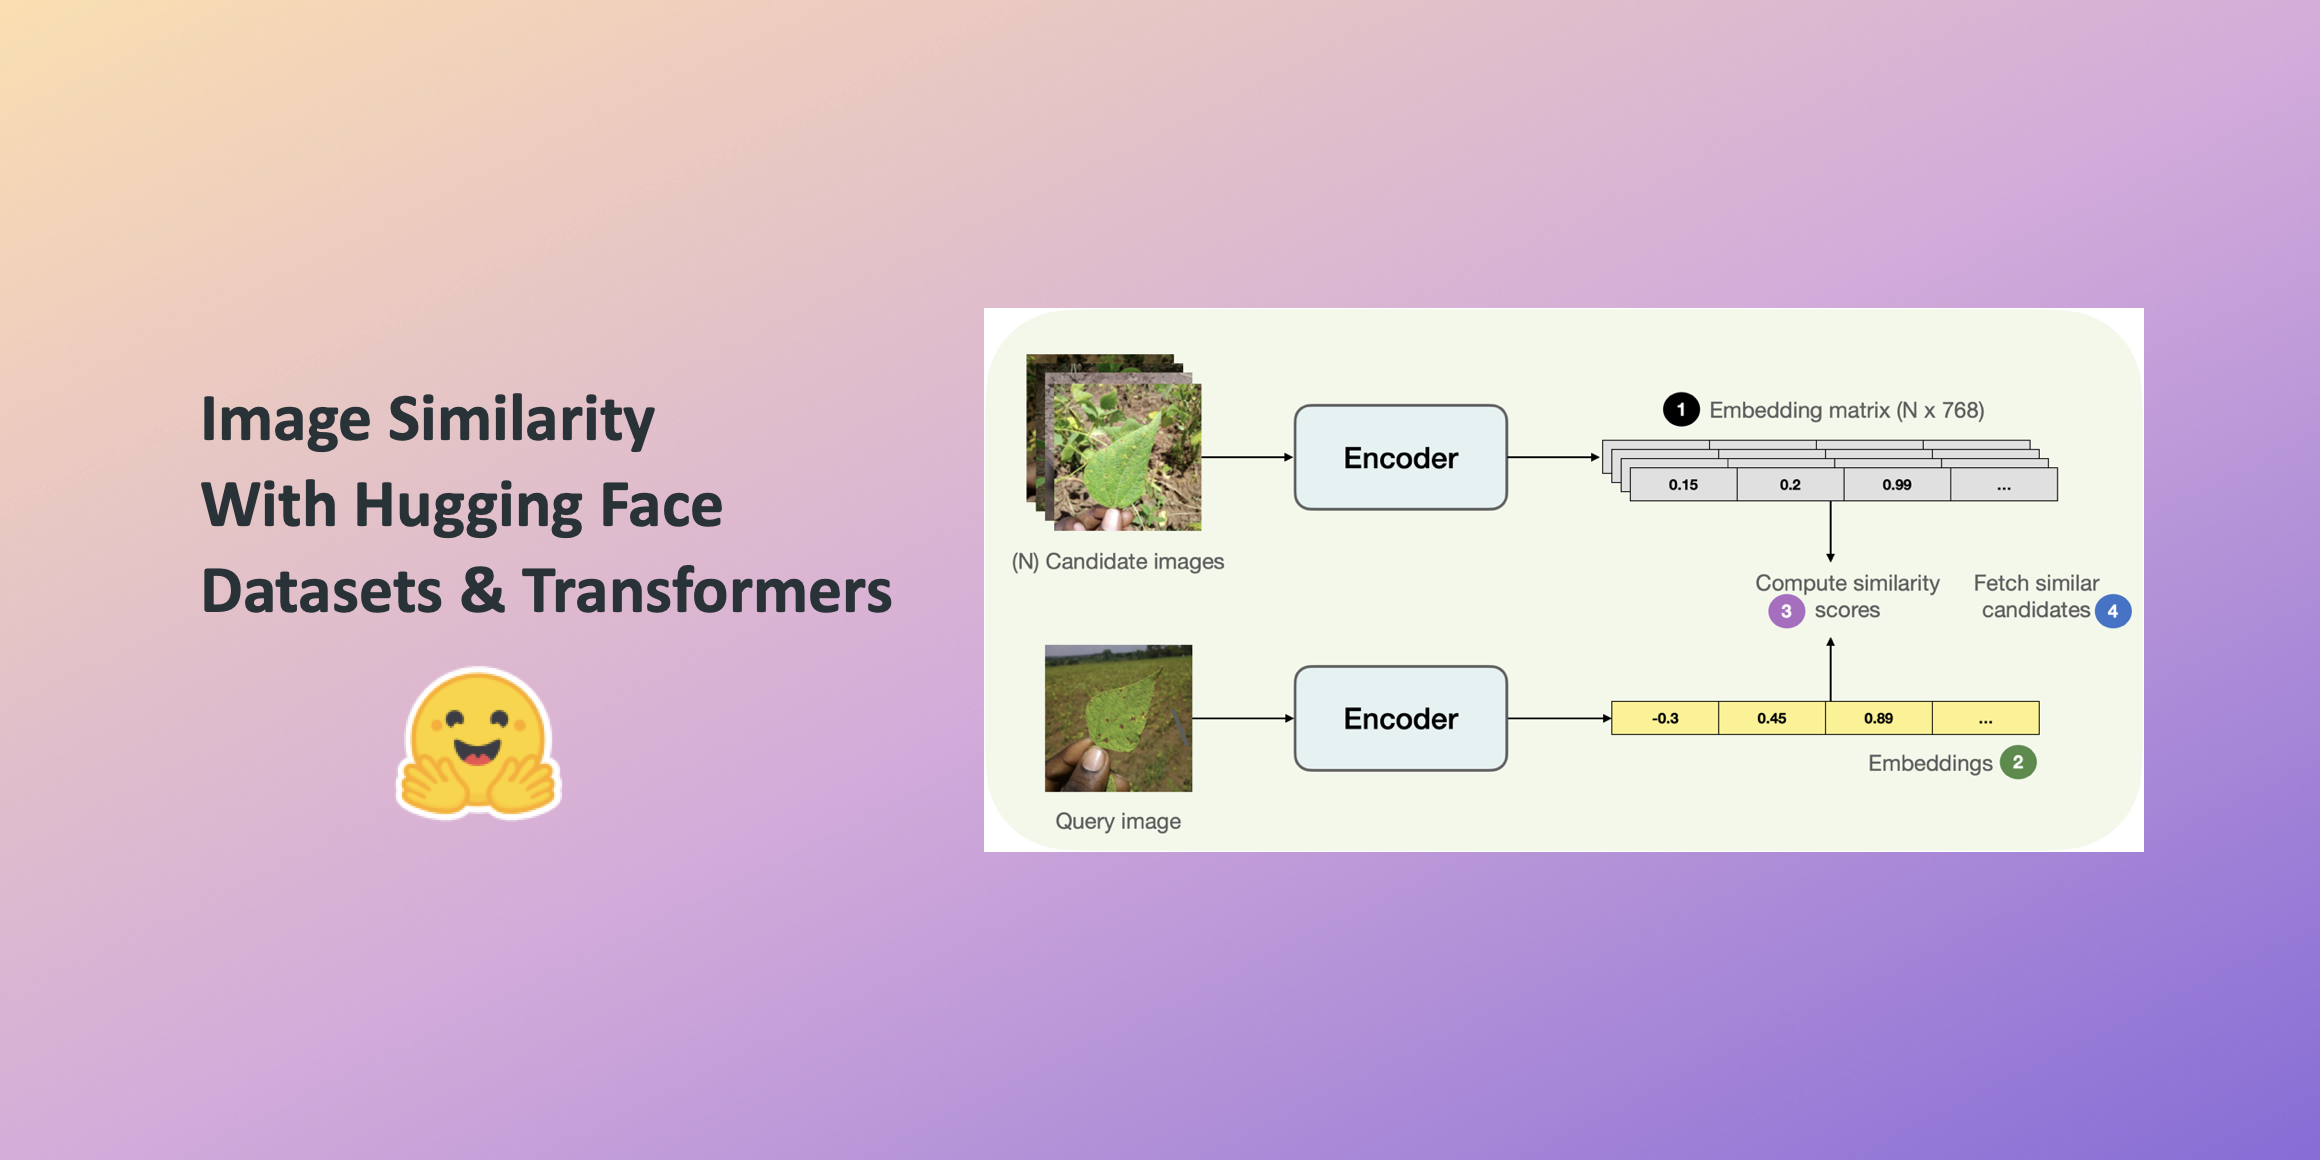
بهجای تفحص در هر پیکسل، روشٔ معمول ابتدا تصویر را به بردارهای جاسازی (Embeddings) تبدیل میکند. این بردار وکال، مقیاسپذیر و برای مقایسهٔ جفتی با فرمولهای فاصلهٔ کوسین یا یکنواخت، امکان محاسبهٔ نمرهٔ مشابهت را فراهم میآورد. در این پروژه، مدل ViT‑Base‑Beans بهعنوان گام ابتدایی انتخاب شده است.
ایجاد و مدیریت مجموعه دادهٔ جفتی
- درک ساختار داده: مجموعهٔ Beans، مجموعه تصاویر برچسبخورده با ویژگیهای مشابه با هدف آزمایش.
- بارگذاری موازی: بهکارگیری کتابخانهٔ datasets برای پردازش موازی و افزودن بردارهای جاسازی بهصورت فهرست جامع.
- بهروزرسانی پویا: امکان اضافه کردن تصاویر تازه و بروزرسانی بردارها بهصورت لحظهای توسط API ذخیرهسازی.
پس از ایجاد فهرست تصویرها و جاسازیهایشان، سیستم آمادهی پردازش پرسشهای تصویر مشابه میشود. الگوی رایج، یافتن k تصویر نزدیکترین و نمایش نمرهٔ مشابهت بهصورت درصدی است.
پایگاهسازی و افزایش مقیاسپذیری
با امکانات زیرساختی Hugging Face، امکان اجرای مدلها در سطح ابری یا بر روی سرورهای محلی فراهم میشود. افزون بر این، سرویس Inference Endpoint بهوسیلهی RESTful APIs، به توسعهدهندگان اجازه میدهد بدون دانش عمیق در زمینهٔ یادگیری ماشین، سیستم مشابهی در اپلیکیشنی تولید کنند.
پرسشهای پرتکرار
چرا از مدل ViT براموز در این سامانه استفاده میشود؟
ViT بهواسطهٔ قدرت آن در پردازش تصاویر بهعنوان توکنهای توابع و کاهش پیچیدگی زمانی در مقایسه با شبکههای کانولوشن، برای استخراج بردارهای جاسازی با کیفیت و مقیاسپذیر مناسب است.
چگونه میتوانم تصاویر جدید را به فهرست مشابهت اضافه کنم؟
با استفاده از API کتابخانهٔ datasets یا سرویس Inference Endpoint، میتوانید تصویر جدید را آپلود کنید، بردار جاسازی آن را تولید کرده و در فهرست ذخیرهسازی خود ثبت کنید؛ سپس رفرش فهرست باعث بروزرسانی خودکار مشابهتها میشود.


