مدل Informer و معرفی چالشهای پیشبینی چندمتغیره
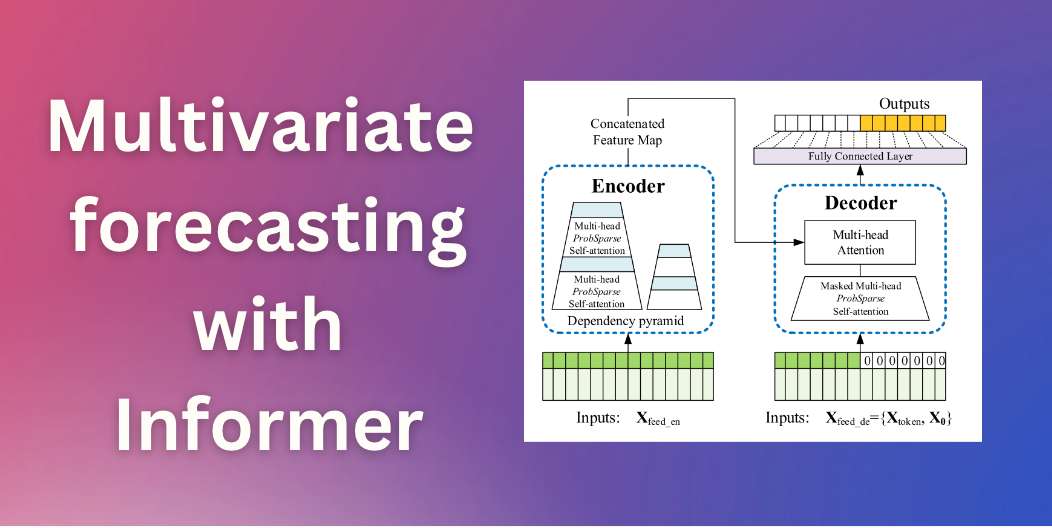
در سالهای اخیر، پیشبینی سریهای زمانی بهعنوان یکی از مهمترین مهارتهای دادهشناسی مطرح شد. مدل Informer در سال ۲۰۲۱ بهعنوان بهترین مقاله AAAI بهدست آمد و با بهکارگیری توجه معکوس ProbSparse قدرت بالایی در پیشبینی چندمتغیره و احتمالاتی ارائه میدهد.
مکانیزم توجه ProbSparse در Informer
یکی از نوآوریهای اصلی Informer استفاده از الگوریتم Perturbation Random Short Attention که باعث کاهش بکارگیری حافظه و سرعت محاسبه میشود. بهوسیله این مکانیزم، مدل نهتنها سرعت در پیشبینی را افزایش میدهد بلکه دقت آن در توزیعهای احتمالی بهطور چشمگیری بهبود مییابد.
گامهای عملی برای پیادهسازی با 🤗 Transformers
برای توسعه مدل در پلتفرم 🤗، کافی است کتابخانهی transformers را نصب کرده و از کلاسی به نام InformerModel بهره ببرید. مراحل زیر را میتوانید دنبال کنید:
- بارگذاری دیتاست و تبدیل آن به قالب PeriodicIndex
- تعریف InstanceSplitter برای تقسیم دادهها به بخشهای آموزشی و آزمایشی
- ساخت DataLoaderهای سفارشی برای همزمانی و برداشتن نرمالسازی
- رایانپیمانی مدل و تحلیل نتایج با ابزارهای plotly و metrics
- استفاده از Inference Endpoints برای سرویسگذاری در کلانسرورها
نتایج و کاربردهای عملی
پروژههای مختلفی همانند پیشبینی مصرف انرژی، گردش مالی شرکتها و رفتار کاربران شبکههای اجتماعی با کمک Informer قابل پیشبینیتر اند. این مدل در حوزههای صنعتی چون انرژی، مالی و سلامت نیز جایگاه خود را پیدا کرده است.
پرسشهای پرتکرار
چه تفاوتی بین Informer و مدل Transformer گام استاندارد دارد؟
Informer با ارزیابی توجه ProbSparse عمل میکند و نیاز به حافظه کم در طول کدتهای طولانیتری دارد، در حالیکه Transformer معمولی انتباه را بهطور کامل محاسبه میکند.
برای چه دیتاستهایی مناسب است Informer؟
این مدل برای دیتاستهای بزرگ چندمتغیره با توالیهای طولانی مناسب است، مثلاً مصرف انرژی و بازارهای مالی، ولی میتواند در دیتاستهای کوچکتر نیز بهصورت تنظیمات مناسب به کار رود.