
مقدمه: VQ‑Diffusion در سنگینی هوش مصنوعی
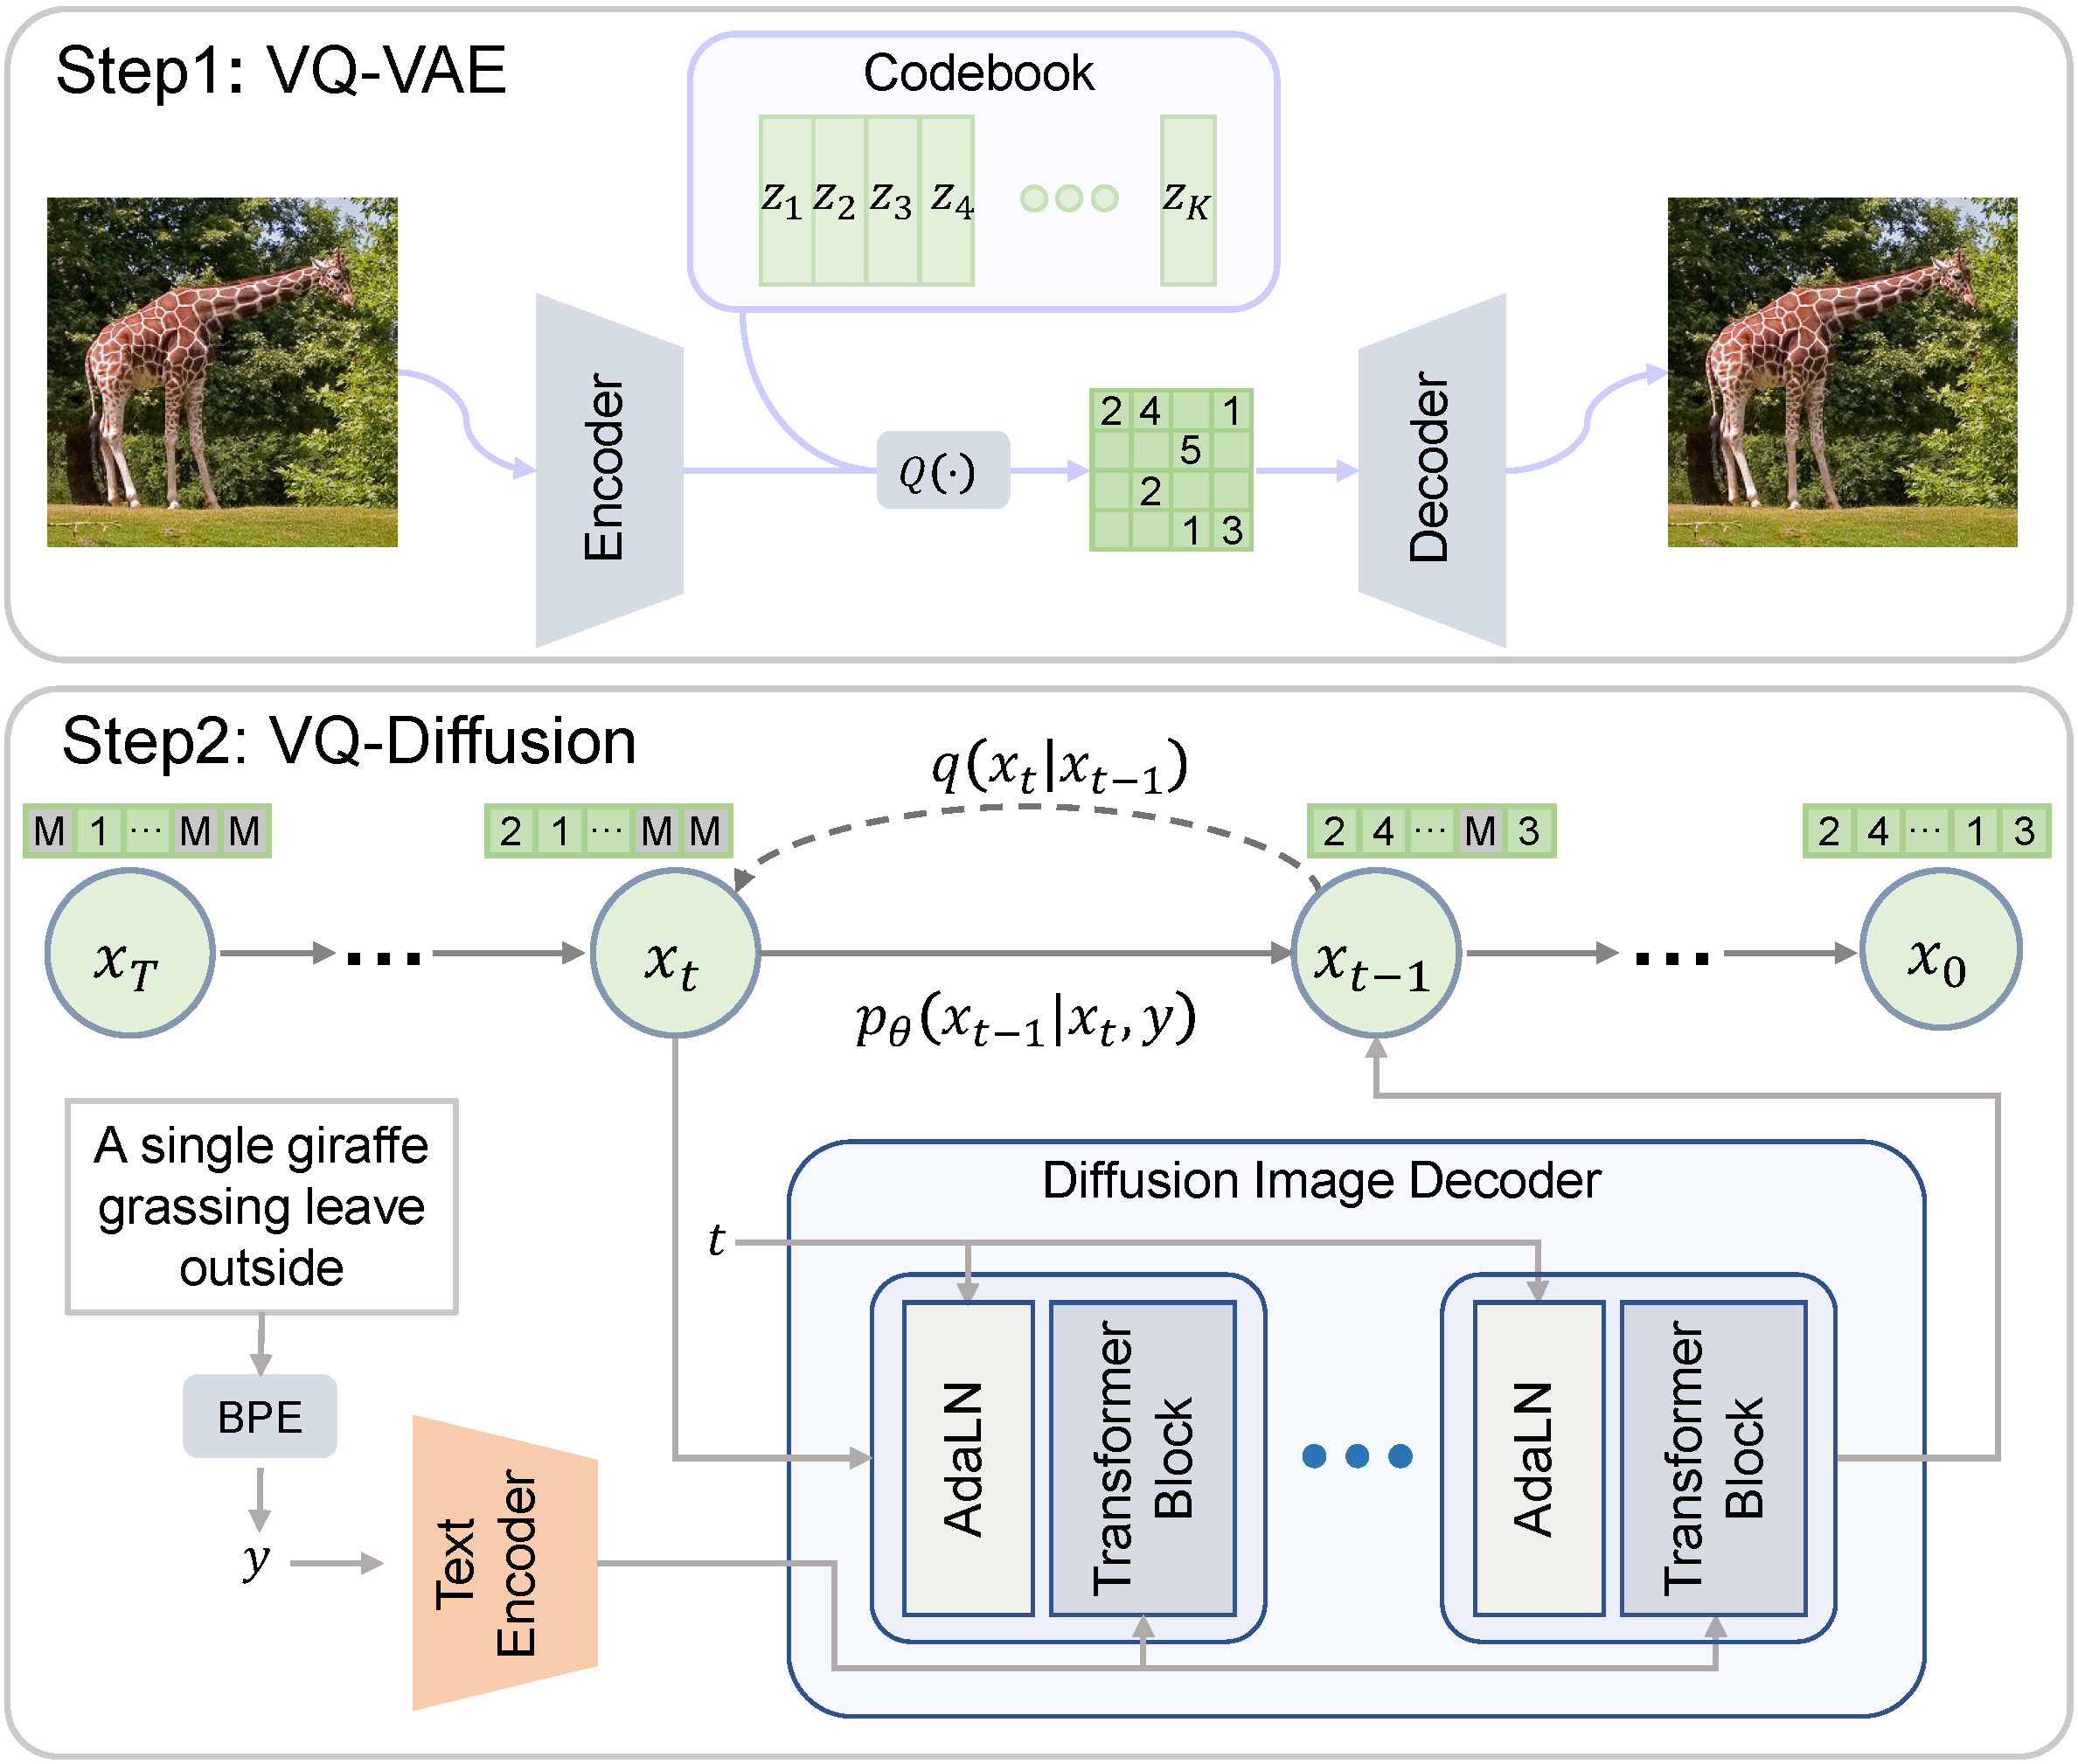
مدل VQ‑Diffusion بهعنوان یک مدل دیفیوزن شرطی در فضای کوانتوم، نوآوری اساسی در حوزه تولید تصاویر محسوب میشود. این مدل بهوسیله توابع VQ‑VAE ابتدا تصاویر را به مجموعهٔ توکنهای گسسته تبدیل کرده و سپس در فضای کوانتیم با فرایندهای افزودن و حذف نویز پیشروی میکند.
معماری VQ‑VAE و تبدیل تصاویر به توکنهای گسسته
در ابتدای مسیر، الگوی VQ‑VAE تصاویر را به یک بردار گسسته تبدیل میکند. این بردارها همان توکنهای ورودی برای مدل دیفیوزن هستند. با استفاده از روش «کواینتیزهکردن»، فضای مستمر تصویر به فضاهای گسسته قابل محاسبه و بهینهسازی تقسیم میگردد.
چگونه VQ‑Diffusion را در پروژههای خود به کار ببریم؟
میتوانید از کتابخانهٔ diffusers در پایتون استفاده کنید. نمونهٔ کد ساده به شکل زیر است:
from diffusers import VQDiffusionPipeline pipe = VQDiffusionPipeline.from_pretrained("microsoft/vq-diffusion-ithq") pipe = VQDiffusionPipeline.from_pretrained("microsoft/vq-diffusion-ithq", torch_dtype=torch.float16, revision="fp16")برای بهرهگیری از کارت گرافیک، مدل را بوسیلهٔ دستورات زیر به GPU منتقل کنید:
pipe.to("cuda")مزایای Model پیشرفته و محیط Open‑Source
- تولید تصاویر گسسته با کیفیت بالا.
- سرعت بالاتر بهدلیل ذخیرهسازی گسسته.
- یکپارچگی با پلتفرمهای Hugging Face و همکاری مجازی.
پرسشهای پرتکرار
VQ-Diffusion چیست و چه کاربردی دارد؟
VQ-Diffusion یک مدل شرطی دیفیوزن است که با استفاده از فضای کوانتومی و توکنهای گسسته تصاویر را تولید میکند. این مدل بهسرعت و کیفیت بالای تولید تصویر، خصوصاً در زمینهٔ ایجاد محتواهای گرافیکی، امکانپذیر میسازد.
VQ-Diffusion در چه جهتهایی از مدلهای دیفیوزن معمولی متمایز است؟
در حالی که مدلهای دیفیوزن سنتی در فضای مستمر عمل میکنند، VQ-Diffusion در فضای کوانتوم بهصورت گسسته عمل میکند؛ این امر باعث کاهش مصرف حافظه، سرعت فرآیندها و بهینهسازی امکانات یادگیری ماشین میشود.


