
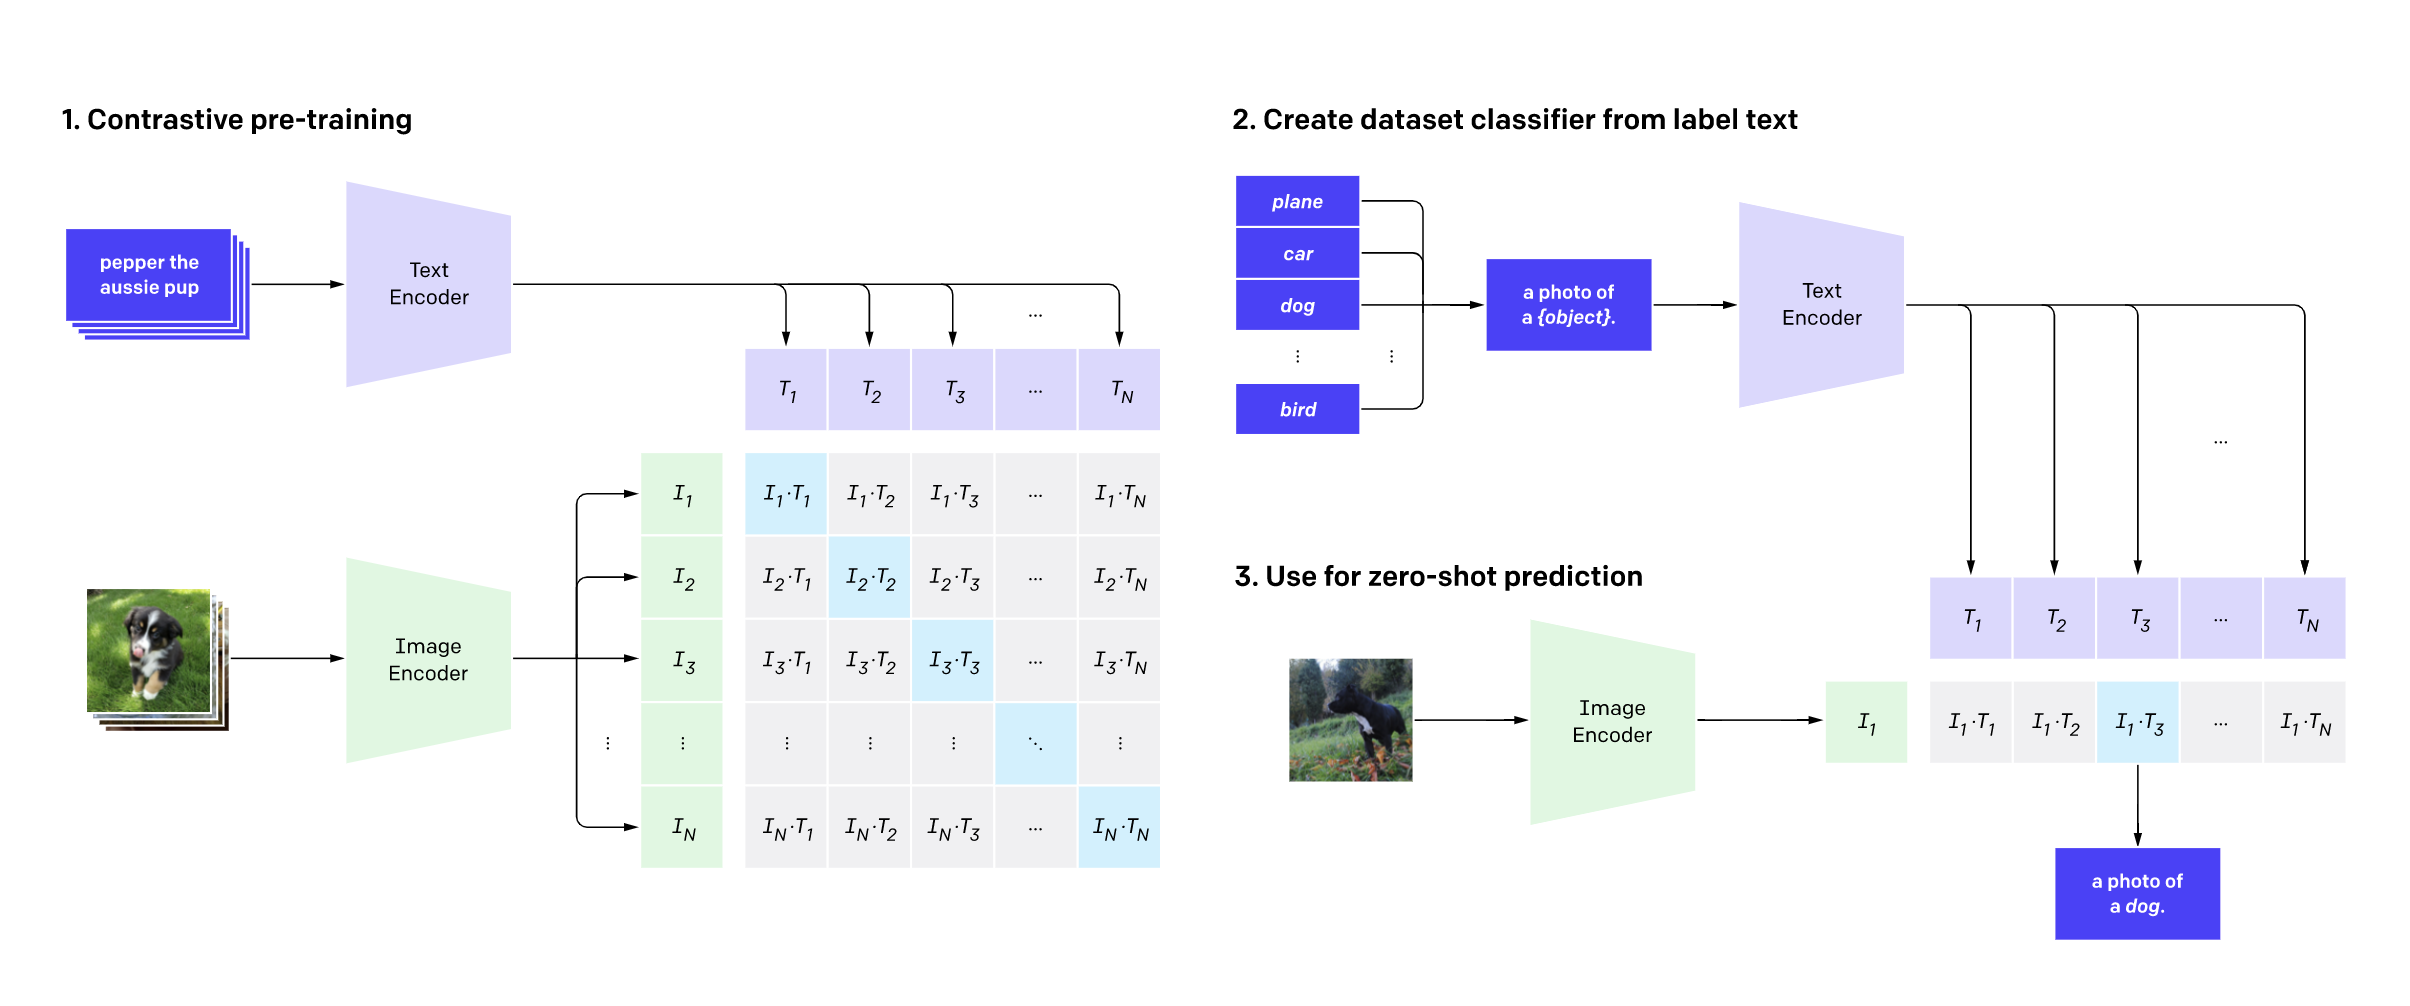
معرفی پروژه
در دسامبر 2021، تحقیقاتی در بالای یک پلتفرم رایگان تحت نام Hugging Face، به فِاینتیون مدل CLIP در حوزهٔ تصاویر ماهوارهای و تسکهای متنی پرداخته بود. هدف این پروژه، آموزش پیشپردازش ویژگیهای بصری و متنداوری تصاویر ماهوارهای برای یادگیری گنجایشهای مشترک تصویر‑متن در زمینهٔ تشخیص جغرافیایی، مانعسازی و ارزیابی دامنهٔ محیطی مختلف است.
مراحل فِاینتیونینگ
کاربردهای اصلی این کار در سه مرحله عملیاتی انجام شد:
- تهیه دیتاست مخلوطیکه تصاویر ریزکالبردی با عناوین یا توضیحات متنیمنطبق، بر اساس مستندات فضا زیستشناسی.
- استفاده از کتابخانههای JAX و Flax برای بهرهگیری از قدرت خودبهتدریج چیستۀ توابع مشتقپذیر، و اجرای مدل در TPUهای رایگان Google Cloud.
- آموزش CLIP روی دادههای استخراج شده، سپس ارزیابی با معیارهای مشابه قضاوت تصویری، و انتشار نتایج در یک اسپیس Demo بهصورت زنده در وبسایت Hugging Face.
پیشنهادات و آینده
نتایج نشان میدهد که فِاینتیون CLIP با تصاویر ماهوارهای بهصورت سریعتر و با دقت بالاتر، نوارهای زمین را بهصورت متنپذیر و هماهنگ با صحنههای بصری استخراج میکند. این مطالعه در راستای ایجاد زیرساختهای هوش مصنوعی آزاد، به اشتراکگذاری مدلهای مدرن، و پیشرفت پژوهشی در تحلیل سیاهچالههای رخدادهای جغرافیایی آینده حرکت میکند.
پرسشهای پرتکرار
CLIP چیست؟
CLIP (Contrastive Language–Image Pre-training) مدلی از شرکت OpenAI است که با اتصال تصاویر به متنها، قابلیت تشخیص و یافتن ارتباط بین دو نوع داده را دارد.
چگونه میتوان تصاویر ماهوارهای را فِاینتیون کرد؟
اولاً دیتاست ترکیبی با تصاویر و توضیحات متن تهیه کنید، سپس با استفاده از کتابخانههای JAX + Flax و پردازشهای موازی در TPU، وزنهای CLIP را بر این دادههای خاص آموزش دهید؛ در نهایت مدل را در هکوج فیس به اشتراک بگذارید.


