
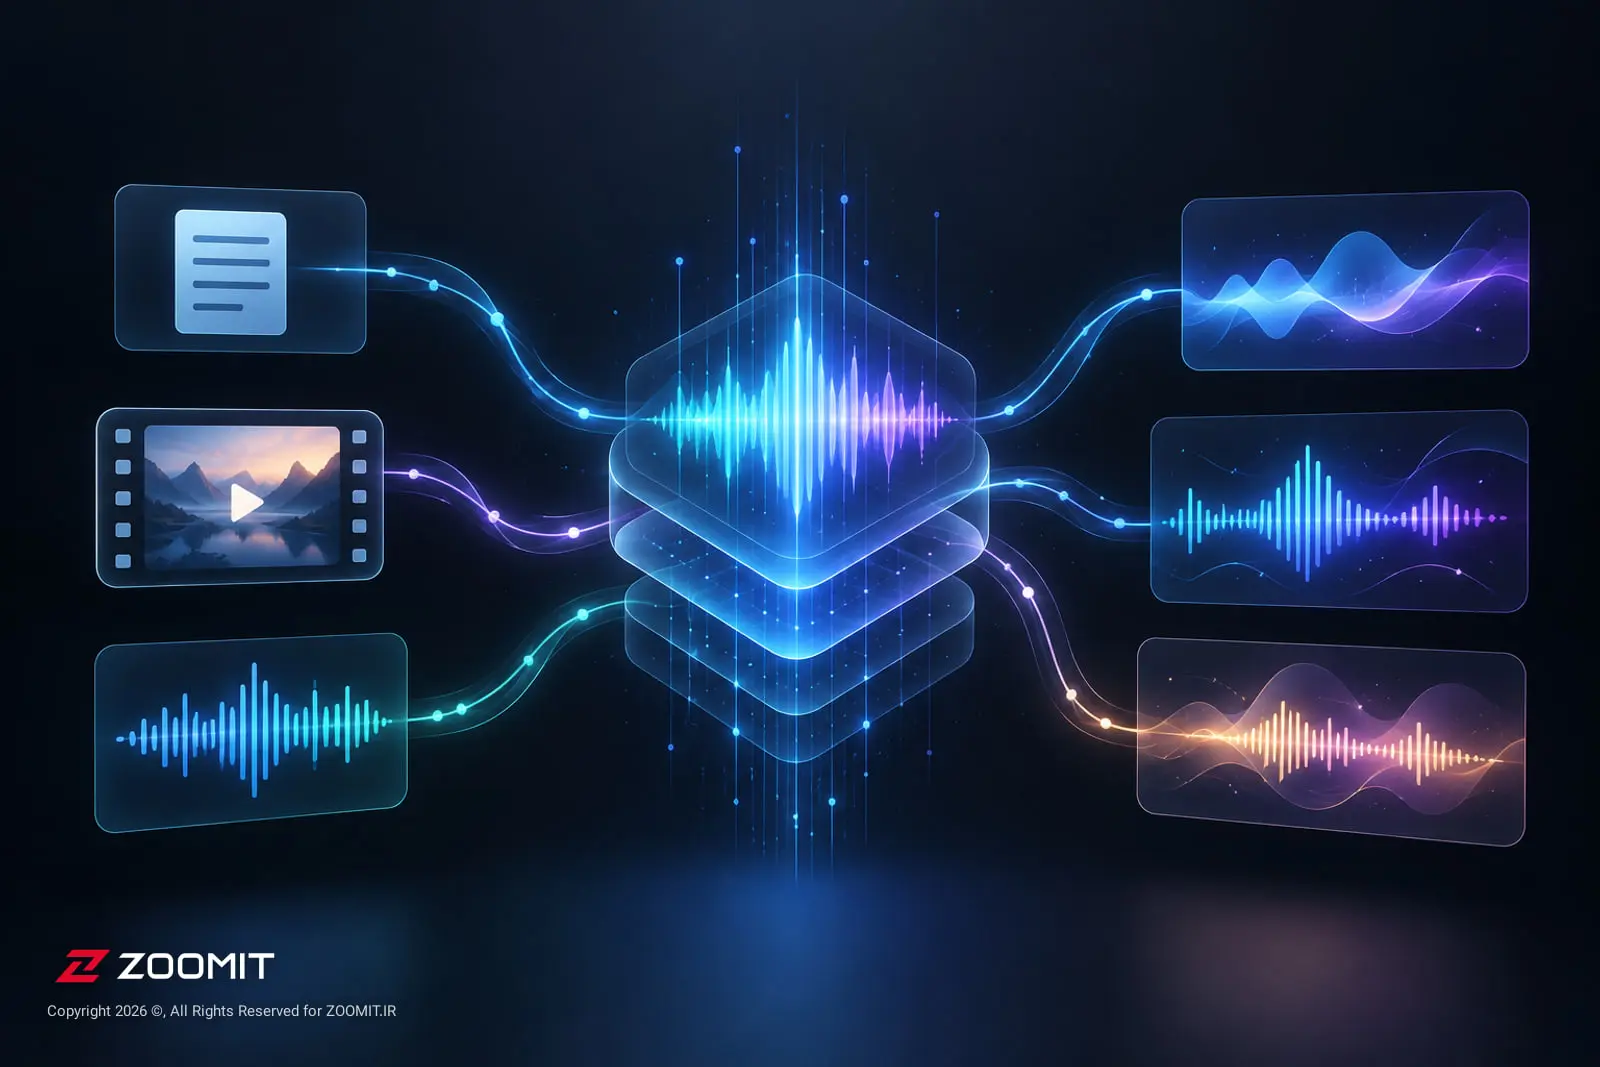
کشف چارچوب چندوجهی AudioX
پژوهشگران حوزهٔ هوش مصنوعی چارچوب نوینی را با نام AudioX توسعه دادهاند؛ سیستمی که از ورودیهای متنوعی نظیر متن، ویدیو و سیگنال صوتی، صدا و موسیقی واقعی تولید میکند.
ماژول MAF: ترکیب ورودیهای نامتجانس
ماژول ادغام تطبیقی چندوجهی (MAF) طراحی شده تا ترکیب دقیقتری از ورودیهای نامتجانس ایجاد کند و هماهنگی میانوجهی را بهبود بخشد. این قابلیت به کاربران امکان میدهد تا برای هر نوع محتوا، صدای بسیار طبیعی و هماهنگی بالایی را به دست آورند.
پیشرفتهای عملی و آینده تولید صدا و موسیقی با هوش مصنوعی
این مدل در سه نسخهٔ مجزا در پلتفرم هگینگیس منتشر شد: نسخه پایه، AudioX-MAF و نسخهٔ پیشرفته AudioX-MAF-MMDiT. ارزیابیهای اولیه نشان داد که AudioX در وظایف متن‑به‑صدا، متن‑به‑موسیقی و پیروی از دستورات پیچیده، عملکرد بسیار بالایی دارد. برای آموزش، پژوهشگران دیتاستی به نام IF‑caps با بیش از ۷ میلیون نمونه ایجاد کردند.
- تولید صدا و موسیقی با کیفیتی نزدیک به ضبط خام
- توانایی ترکیب فوری ورودیهای متنی، صوتی و تصویری
- پشتیبانی از دستورات پیچیده و مدلسازی صداهای متفاوت
پرسشهای پرتکرار
AudioX چگونه بر تولید صدا تأثیر میگذارد؟
AudioX با ادغام ورودیهای متن، ویدیو و سیگنال صوتی، امکان تولید صداهای طبیعی و هماهنگ را در یک چارچوب آبرونی فراهم میکند؛ این مدل باعث کاهش خطاهای پردازشی و افزایش کیفیت خروجی میشود.
آیا مدل MAF در تولید موسیقی کاربرد دارد؟
بله، ماژول MAF قابلیت ترکیب اطلاعات چندوجهی را داشته و در تولید موسیقی از متن یا ویدیو، انسجام ریتمیک و هارمونیک را تضمین میکند.


