
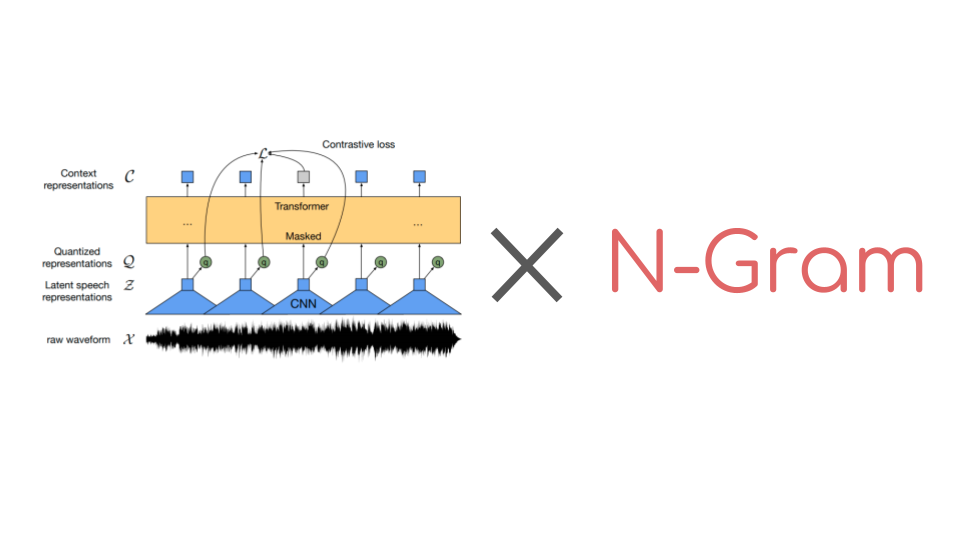
Wav2Vec2 و چالشهای تشخیص گفتار
Wav2Vec2، مدل پیشمجموعهای که در سپتامبر ۲۰۲۰ توسط Meta AI Research معرفی شد، با استفاده از کلاسیکالتوابع خودیادگیری، توانسته پیشرفت قابل توجهی در تشخیص گفتار ایجاد کند. این مدل بر پایه معماری connectionist temporal classification (CTC) کار میکند و با یک لایه خطی ساده قابل فاینتویند برای دستیابی به تشخیص دقیق است.
ن‑gram چگونه میتواند بهبود یابد
چون مدلهای صوتی تنها تمام اطلاعات صوتی را پردازش میکنند، ترکیب آن با یک مدل زبان (LM) برای تولید متن نهایی ضروری است. استفاده از n‑gram بهوسیله KenLM، الگوهای زبانی را استخراج میکند و بهعنوان مکملی قوی برای مدل صوتی عمل میکند، که باعث کاهش خطاهای فیوژن فرکانسها و بهینهسازی دقت نهایی میشود.
راهاندازی در 🤗 Transformers و نتایج حاصل
برای فعالسازی این ترکیب، در Hugging Face یک لایه خطی بر روی پشته Wav2Vec2 اضافه میشود و سپس n‑gram پیشپردازششده را از KenLM در Pipeline قرار میدهیم. نتایج آزمایشی نشان میدهد که دقت Word Error Rate (WER) در مقایسه با فاینتویندهای ۲۵۰ک ناتوانییی، حدود ۱۰ درصد بهبود یافته است.
- پایگاه دادههایی مانند Common Voice، LibriSpeech برای فاینتویند منابع اصلی هستند.
- کتابخانه KenLM برای ساخت مدل n‑gram بهینه و سریع.
- مستندسازی کامل در بخشهای Hugging Face Hub و Transformers Docs در دسترس است.
پرسشهای پرتکرار
Wav2Vec2 چرا برای تشخیص گفتار مناسب است؟
این مدل از شبکههای convolutional و transformer برای استخراج ویژگیهای صوتی استفاده میکند و با CTC طی فرآیند برچسبگذاری سیگنالهای صوتی، یادگیری بدون برچسب را ممکن میسازد.
نـ‑gram در ترکیب با Wav2Vec2 چه تاثیری دارد؟
ن‑gram الگوهای تکراری زبانی را شناسایی میکند، در نتیجه اشتباهات مربوط به ترکیب همان کلمات در زمان تبدیل صوت به متن کاهش مییابد و دقت نهایی بهبود مییابد.


