پیشینه جدید مدلهای زبانی بزرگ
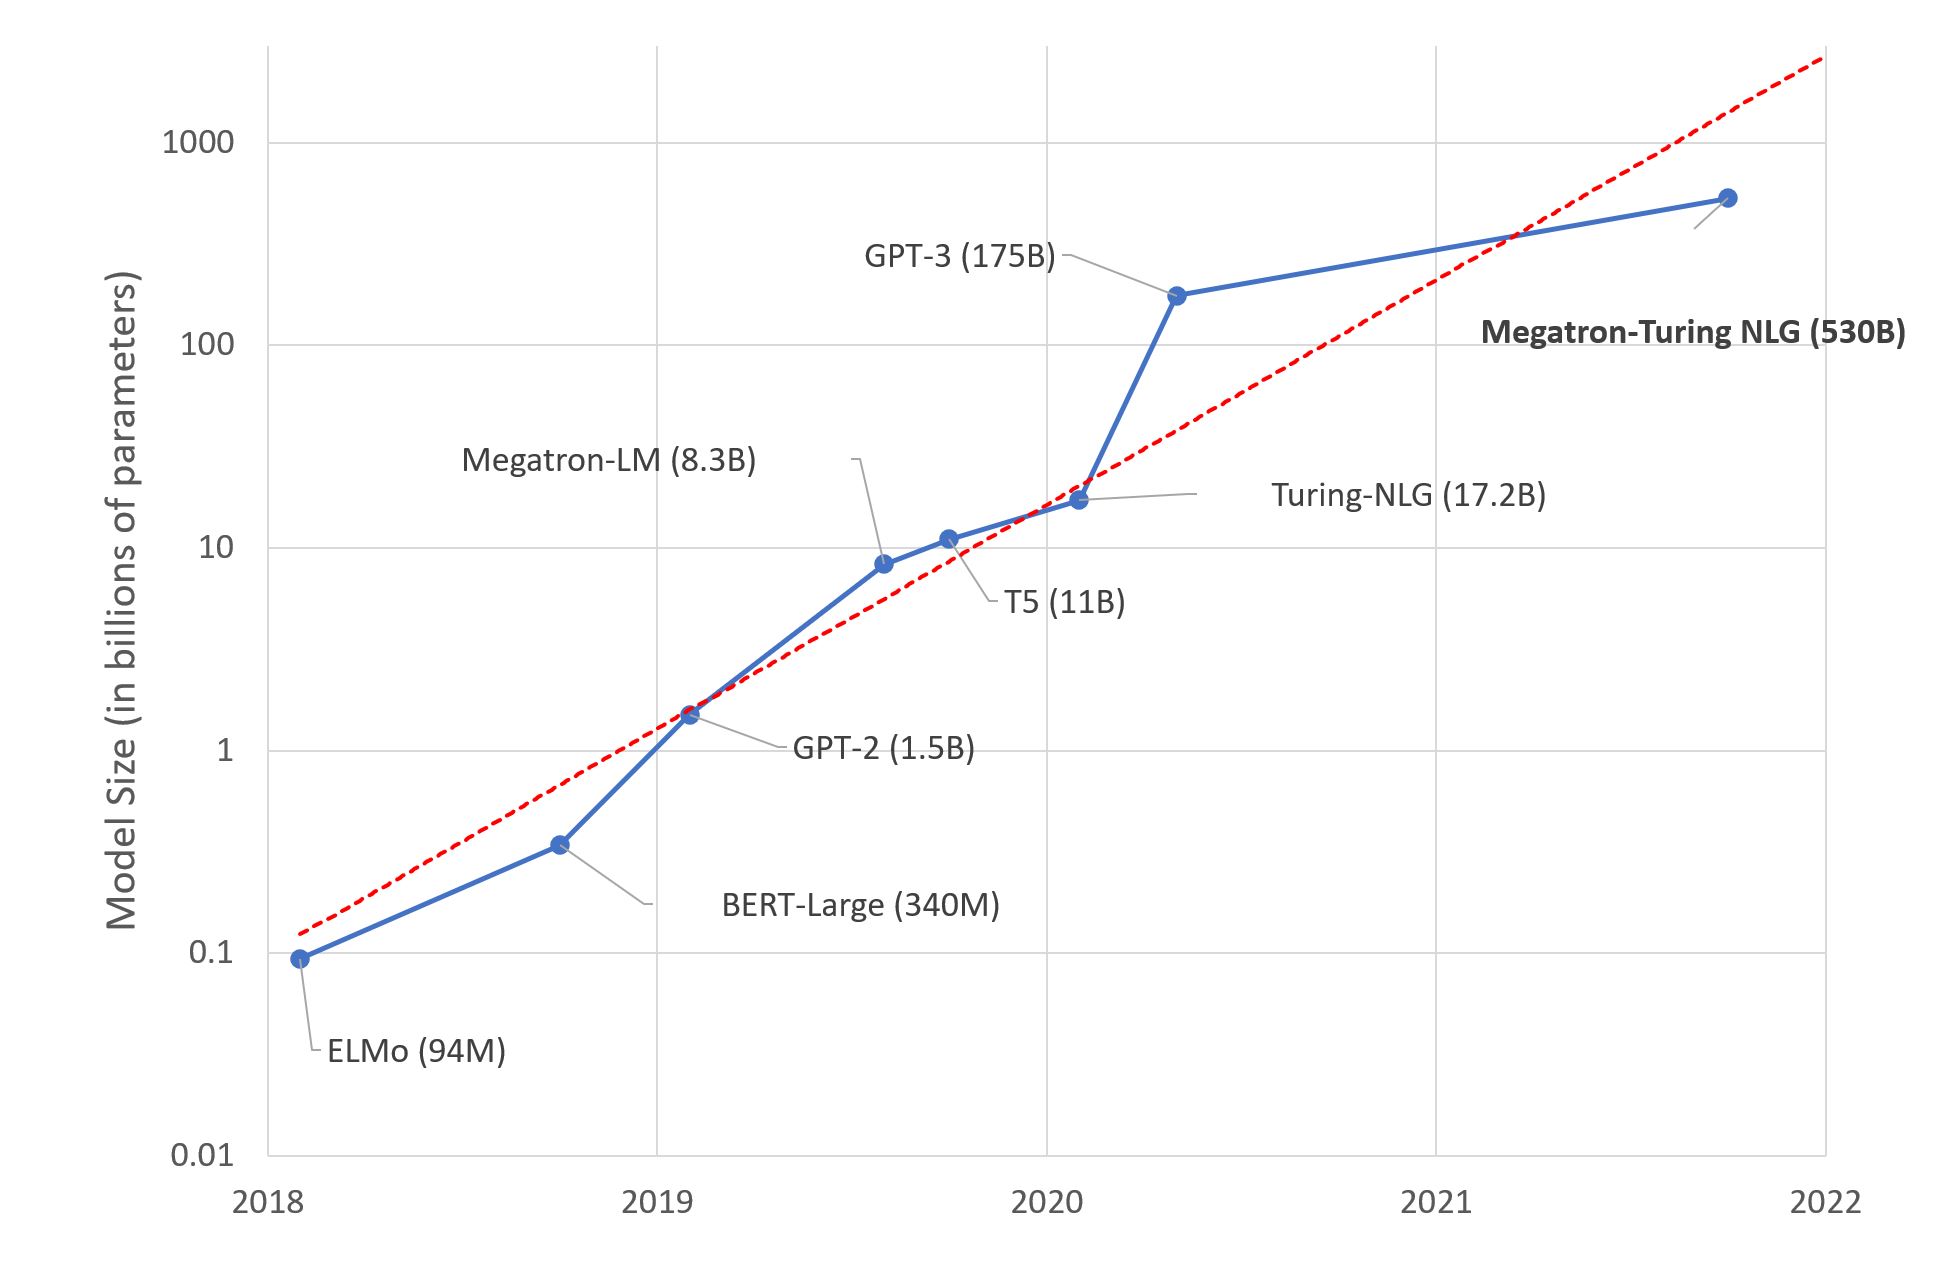
در سپتامبر 2021، شرکتهای Microsoft و NVIDIA با معرفی Megatron‑Turing NLG 530B، جایگاه خود را در برتری مدلهای زبانی تقویت کردند. این مدل، با 530 میلیارد پارامتر، نه تنها بزرگترین مدل در زمان خود بود، بلکه نمونهای از شریکسازی سختافزاری و نرمافزاری در فضای یادگیری عمیق است.
چرا اندازه مدلهای ۱۰۰ میلیارد پارامتری راضی نیست؟
پرسشهای بنیادین در مورد بهرهوری، مصرف انرژی، و دسترسی معنیدار مطرح میشود. بهعلاوه، مقایسه ۱۰۰ میلیارد پارامتر با ۸۶ میلیارد نورون مغزی انسان، معادلسازی نامناسبی است؛ زیرا ہر مغز بیش از ۱۰۰ ترلیون سیناپس دارد که در غیرفاز پارامتر، به جای ویژگی، توانایی یادگیری را تضمین میکند.
چشمانداز آینده: مدلهای کوچک و کاربردی
انجمن پژوهشی و صنعتی در حال تغییر است. متنباز بودن Hugging Face، بهعنوان یک پلتفرم مشترک، کمک میکند تا مدلهای متنوع بهسرعت بهبود یابند. تمرکز بر مدلهای کوچکتر، بهینهسازی معماری، و فراگیری بدون نیاز به GPUS پیشرفته، مسیر اصلی آینده به شمار میآید.
- استفاده از مدلهای پیشآموزش (pre‑trained) برای مشخص کردن وظایف خاص
- آموزش فینتئوئن با دادههای محدود، برای صرفهجویی در هزینه
- استفاده از سرورهای ابری، با امکان مقیاسپذیری پویا در زمان اجرا
- بهینهسازی مدل برای مصرف انرژی مناسب در دستگاههای موبایل
- یکپارچهسازی با سامانههای مدیریت داده برای پشتیبانی از فلو نی لاپ و در اختیار تعمیری
در نهایت، مدلهای کوچک ولی کارآمد، میتوانند الگوی پراکندگی فناوری هوش مصنوعی را نسبت به نسلهای بزرگتر بهبود دهند و دسترسی گستردهتری ایجاد کنند.
پرسشهای پرتکرار
چرا Megatron‑Turing NLG 530B بهعنوان یک مدل بزرگ تلقی میشود؟
این مدل با داشتن 530 میلیارد پارامتر، در زمان معرفی خود بزرگترین مدل زبان موجود بود؛ اما اندازهی پارامتر فقط یک معیار از مهارت مدل است.
مدلهای کوچکتر واقعیترین راهکار برای توسعه هوش مصنوعی است؟
بله، مدلهای کوچکتر معمولا مصرف انرژی کمتر، آموزش سریعتر و قابلیت پیادهسازی در دستگاههای محدود را دارند؛ این عوامل بالاترین بهرهبرداری را در دنیای واقعی تضمین میکنند.