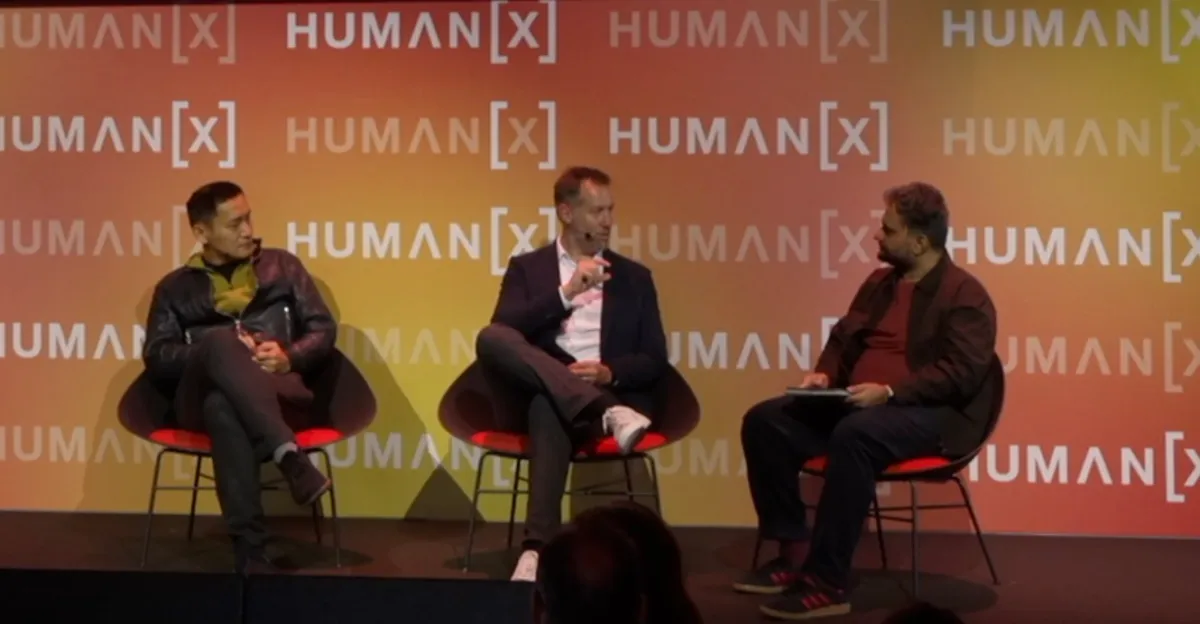
هوش مصنوعی صوتی مدتی است که به عنوان رابط بزرگ بعدی فناوری معرفی میشود و سرمایهگذاران میلیاردها دلار روی استارتاپهای مختلف این حوزه سرمایهگذاری کردهاند. از مدلهای زبانی صوتی و خدمات مشتری سازمانی گرفته تا ابزارهای یادداشتبرداری و دیکته هوشمند، هر هفته مدل یا ابزار جدیدی معرفی میشود که ادعا میکند میتواند مانند انسان صحبت کند و گفتگو داشته باشد. با این حال، مدیران فعال در این صنعت بر این باورند که هوش مصنوعی صوتی هنوز نتوانسته به نقطه عطف مهمی که «لحظه ChatGPT» مینامند، دست یابد.
وضعیت فعلی هوش مصنوعی صوتی
با وجود تبلیغات گسترده و سرمایهگذاریهای کلان، واقعیت میدانی نشان میدهد که سیستمهای هوش مصنوعی صوتی همچنان با چالشهای جدی مواجهاند. مدلهای تمامدوطرفه (full-duplex) که توانایی صحبت کردن همزمان با شنیدن را دارند، پیشرفت بزرگی محسوب میشوند، اما شاون ون، مدیر فناوری پلتفرم PolyAI، معتقد است که این فناوری هنوز به «لحظه ChatGPT» خود نرسیده است. به عبارت دیگر، هنوز محصولی وجود ندارد که بتواند تجربهای انقلابی و واقعاً هوشمند از تعامل صوتی ارائه دهد.
مشکل اصلی: عدم درک صحیح زمینه
به گفته مدیران این حوزه، بزرگترین مشکل هوش مصنوعی صوتی به لایه زمینه (context layer) بازمیگردد. این سیستمها اغلب نکات کلیدی مکالمه را از دست میدهند و همین امر باعث میشود کل زنجیره پردازش بشکند. به عبارت دیگر، اگر الگوریتم نتواند معنای دقیق گفتههای کاربر را در بافت موقعیتی و زبانی درست متوجه شود، خروجی نهایی نیز غیرقابل اعتماد خواهد بود.
- از دست دادن نکات مهم گفتگو و ایجاد اختلال در درک کامل منظور کاربر
- وابستگی شدید به کیفیت دادههای آموزشی و ناتوانی در انطباق با لهجهها و لحنهای متنوع
- عدم وجود یکپارچگی لازم بین پردازش زبان طبیعی و مدیریت مکالمه بلندمدت
- شکست زنجیره پردازش در مواجهه با جملات پیچیده یا ارجاع به بخشهای قبلی مکالمه
آینده و چشمانداز پیش رو
هرچند هوش مصنوعی صوتی هنوز به بلوغ کامل نرسیده است، اما پتانسیل بالایی برای تبدیل شدن به یکی از اصلیترین رابطهای کاربری در آینده دارد. به عقیده تحلیلگران، رسیدن به «لحظه ChatGPT» در حوزه صوتی نیازمند بهبود اساسی در درک زمینه، حافظه مکالمه و توانایی مدیریت خطاهاست. تا آن زمان، همچنان شاهد شکاف بین ادعای شرکتها و تجربه واقعی کاربران خواهیم بود.