محصول جدید Dell Enterprise Hub
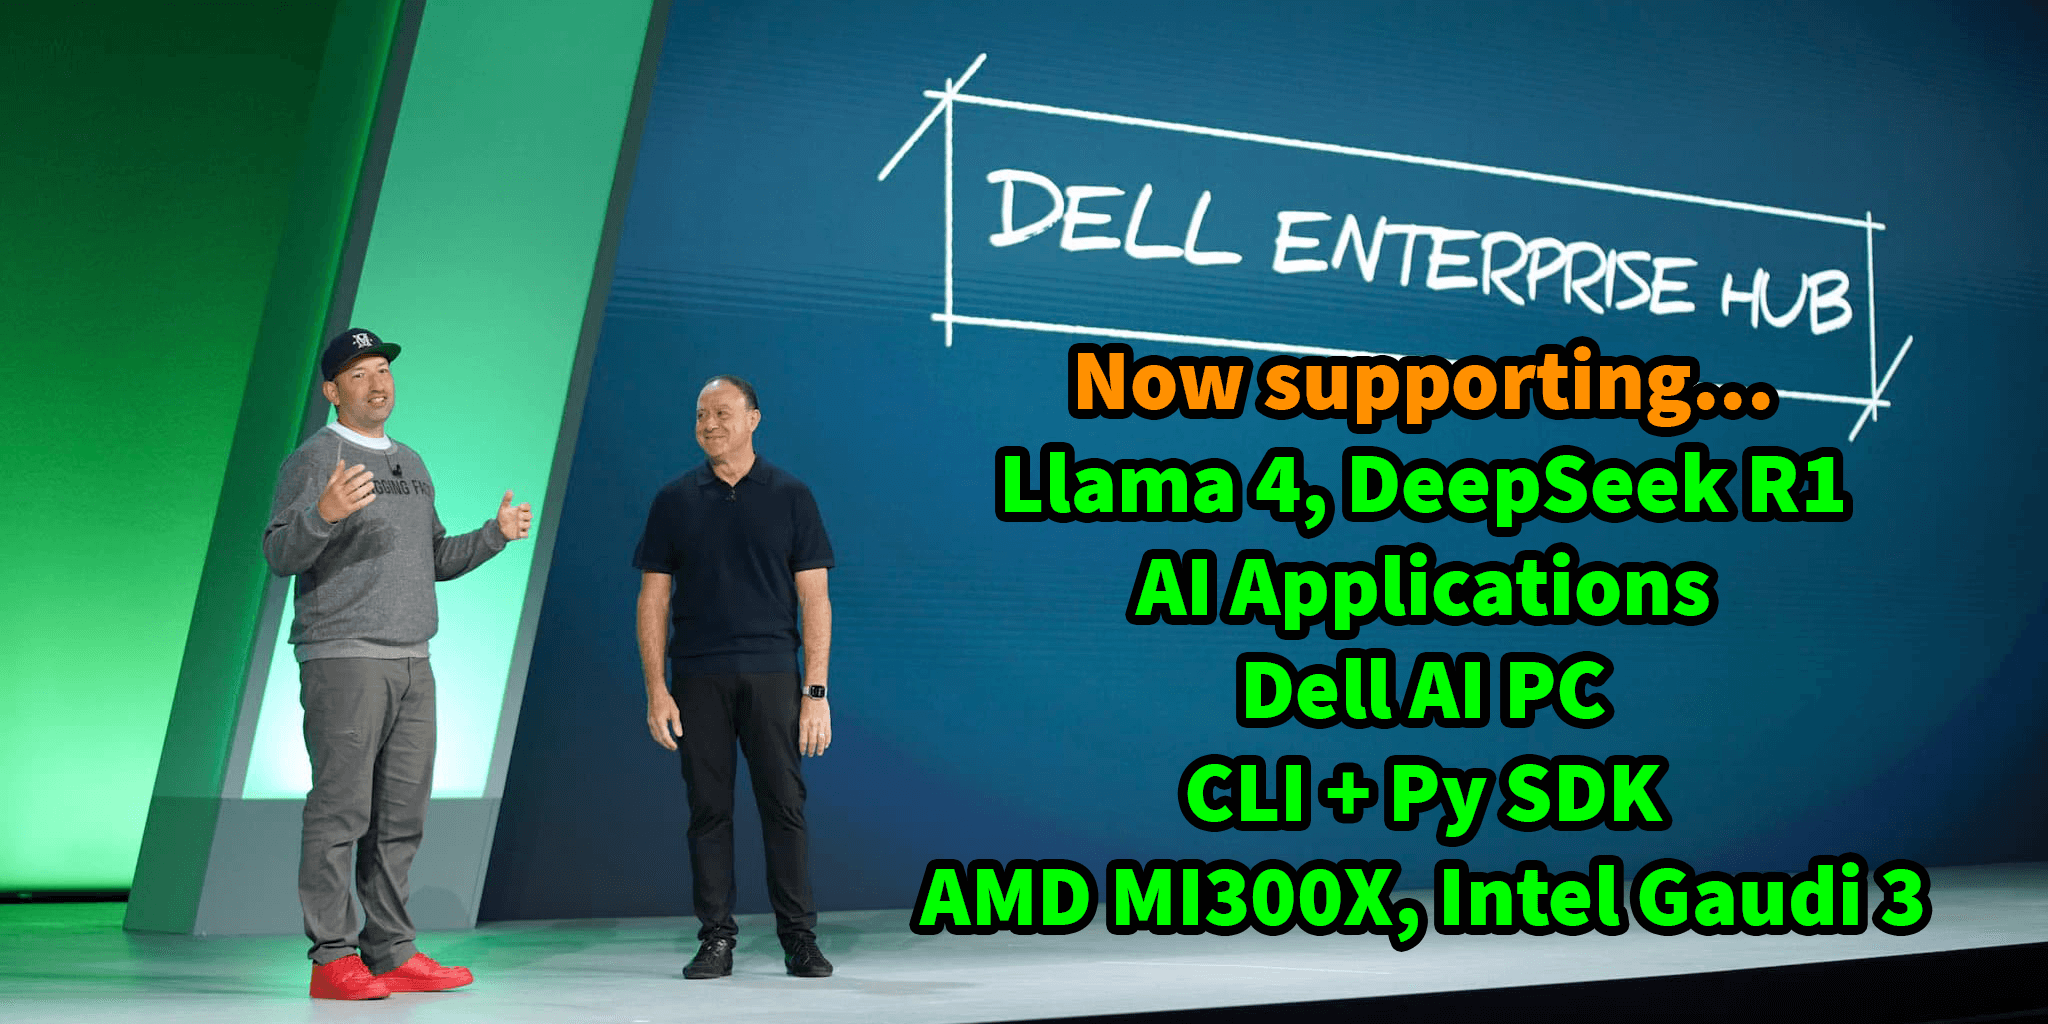
در آخرین رویداد Dell Tech World، شرکت Dell معرفی کرد که در قالب یک پلتفرم جامع، به شرکتها امکان میدهد مدلهای هوش مصنوعی را بهصورت داخلی روی سرورهای خود پیادهسازی کنند. با بهرهگیری از سختافزارهای پیشرفته NVIDIA، AMD و Intel، این پلتفرم قابلیت اجرای مدلهای یادگیری عمیق را در محیطهای تولیدی بدون نیاز به ابر فراهم میکند.
مدلهای آماده برای بهرهبرداری
حالا اگر به وبسایت Dell Enterprise Hub سر بزنید، میتوانید مدلهای مشهور مثل Meta Llama 4 Maverick، DeepSeek R1، یا Google Gemma 3 را بهصورت یککلیک برای آموزش یا پیشبینی انتخاب کنید. هر مدل در قالب یک کانتینر کاملاً تستشده برای پلتفرمهای سرور خاص Dell (مثل Dell PowerEdge) آماده است و با دستورات ساده Docker و Kubernetes قابل استقرار است.
گامهای ساده برای اجرا در سرورهای Dell
مدل انتخابی را میتوانید روی سرورهای NVIDIA H200، AMD MI300X یا سرورهای Dell PowerEdge اجرا کنید. این فرآیند شامل دانلود کانتینر، اجرای Docker یا deployment روی Kubernetes میباشد؛ بهعلاوه، Dell یک CLI و SDK پایتون برای مدیریت و مانیتورینگ مدل فراهم کرده است. بهعبارت دیگر، همه چیز برای شما در همان صفحه مرکز Dell Enterprise Hub آماده است.
- مدلها در کانتینرهای معتبر قرار دارند و با Docker و Kubernetes قابل استقرار هستند.
- هر مدل بهصورت پیشساز برای سرورهای NVIDIA H200 و AMD MI300X بهینهسازی شده است.
- CLI و SDK پایتون برای مدیریت، مانیتورینگ و آزمایش مدل در محیطهای داخلی ارائه میشود.
پرسشهای پرتکرار
چگونه میتوان یک مدل مخصوص Dell Enterprise Hub را در سرورهای خود نصب کرد؟
ابتدا مدل موردنظر را از بازتابهای متاح در Hub انتخاب کنید، سپس دستورهای Docker یا Kubernetes را طبق مستندات وجوهدار برای سرور مناسب اجرا کنید؛ در صورت نیاز از CLI یا SDK پایتون برای مدیریت استفاده کنید.
دلیل مهم بودن کانتینرهای آمادهسازی برای مدلهای هوش مصنوعی چیست؟
کانتینرها ویژگی اتصال سریع، سازگاری کامل با سختافزار و مراقبت از وابستگیهای نرمافزاری را تضمین میکنند؛ این امر به سازمانها امکان میدهد بدون زمان طولانی برای تنظیم، مدلهای خود را بهسرعت در محیطهای تولیدی اعمال کنند.