مقدمه
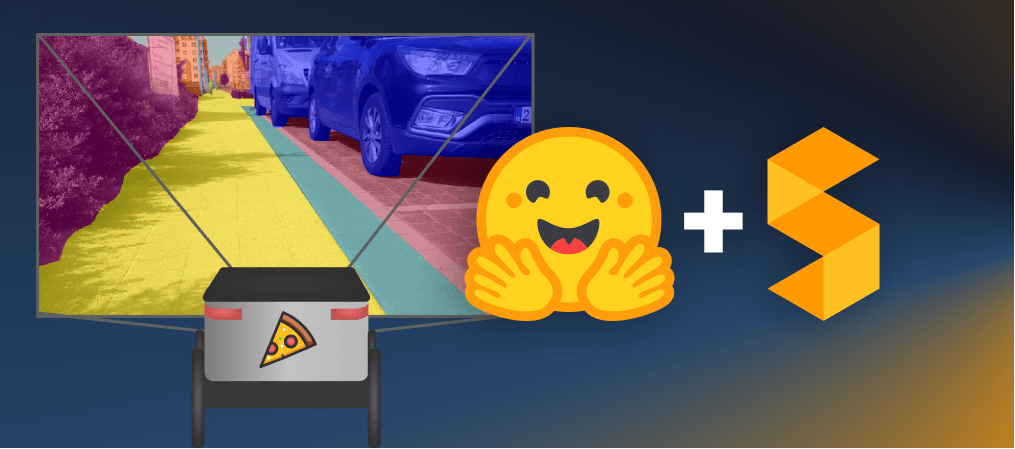
هوش مصنوعی روز به روز در زمینههای مختلف زندگی نقش مهمتری ایفا میکند. یکی از وظایف جذاب بخش هوش مصنوعی، شناسایی دقیق هر پیکسل در یک تصویر است که به آن Semantic Segmentation میگویند. در این نوشتار، به بررسی روند فاینتون کردن مدل SemSeg فوقالعاده و کاربرد آن در روبات تحویل پیتزا میپردازیم.
آمادهسازی مجموعه داده
گام اول، انتخاب یا ساخت مجموعه داده مخصوص به خودست. میتوانید از دیتاستهای موجود در کانال دادهها استفاده کنید یا دادههای خاص خود را تجزیه و تحلیل کنید. سپس با استفاده از کتابخانهٔ datasets، دادهها را بارگذاری و پیشپردازش میکنیم. در این مرحله پردازش تصویر، نرمالسازی و افزایش داده (augmentation) انجام میشود تا مدل از تنوع بیشتر بیاموزد.
فاینتون کردن مودل SegFormer
در ادامه، مدل پیشآموزشیافتهٔ SegFormer را از Hugging Face بارگذاری میکنیم. سپس با استفاده از Trainer محیط آموزش را راهاندازی میکنیم. با تنظیم پارامترهای مناسب، مدل را بر روی مجموعه دادهٔ خود فاینتون میکنیم؛ در نهایت، وزنهای آموزش دیده در هاب ذخیره میشوند.
اعمال برروی روبات تحویل پیتزا
هدف نهایی، بهرهبرداری از مدل در روبات تحویل پیتزا است تا بتواند مسیر را درک کرده و موانع را شناسایی کند. مدل فاینتونشده را در محیط روبات اعمال میکنیم و با تستهای میدانی، عملکرد دقیق مدل در پیشبینی مسیر و شناسایی اشیاء اطراف را ارزیابی میکنیم.
نتیجهگیری
این راهنمای کوتاه نشان داد که چگونه میتوان یک مدل SemSeg پیشرونده را به صورت آسان، فاینتون کرده و برای کاربردهای خاص مانند روبات تحویل پیتزا استفاده نمود. میتوانید همینحال کدها را از مستودع مخزن دریافت کرده و عملی کنید.
- انتخاب یا ساخت دیتاست مناسب
- بارگذاری و پیشپردازش با Hugging Face Datasets
- فاینتون کردن با استفاده از Trainer و پارامترهای بهینه
- ارزیابی و تست روی دادهٔ واقعی محیط روبات
- استفاده در محیط واقعی روبات تحویل پیتزا
پرسشهای پرتکرار
فاینتون کردن مدل SemSeg چه فوایدی دارد؟
فاینتون کردن مدل SemSeg به ویژه در محیطهای خاص، دقت تشخیص را بهبود میبخشد؛ مدل میتواند ویژگیهای خاصِ دیتاست را بیاموزد، بهطوریکه در شرایط واقعی دقت بالاتری داشته باشد.
چگونه میتوان دیتاست مناسب برای فاینتون انتخاب کرد؟
دقت در انتخاب دیتاست بسیار مهم است؛ باید دیتاستی داشت که شامل تصاویر با ویژگیهای مشابه با محیط هدف باشد، برچسبهای دقیق داشته باشد و اندازهٔ کافی نمونه درستی برای یادگیری ارائه دهد.