
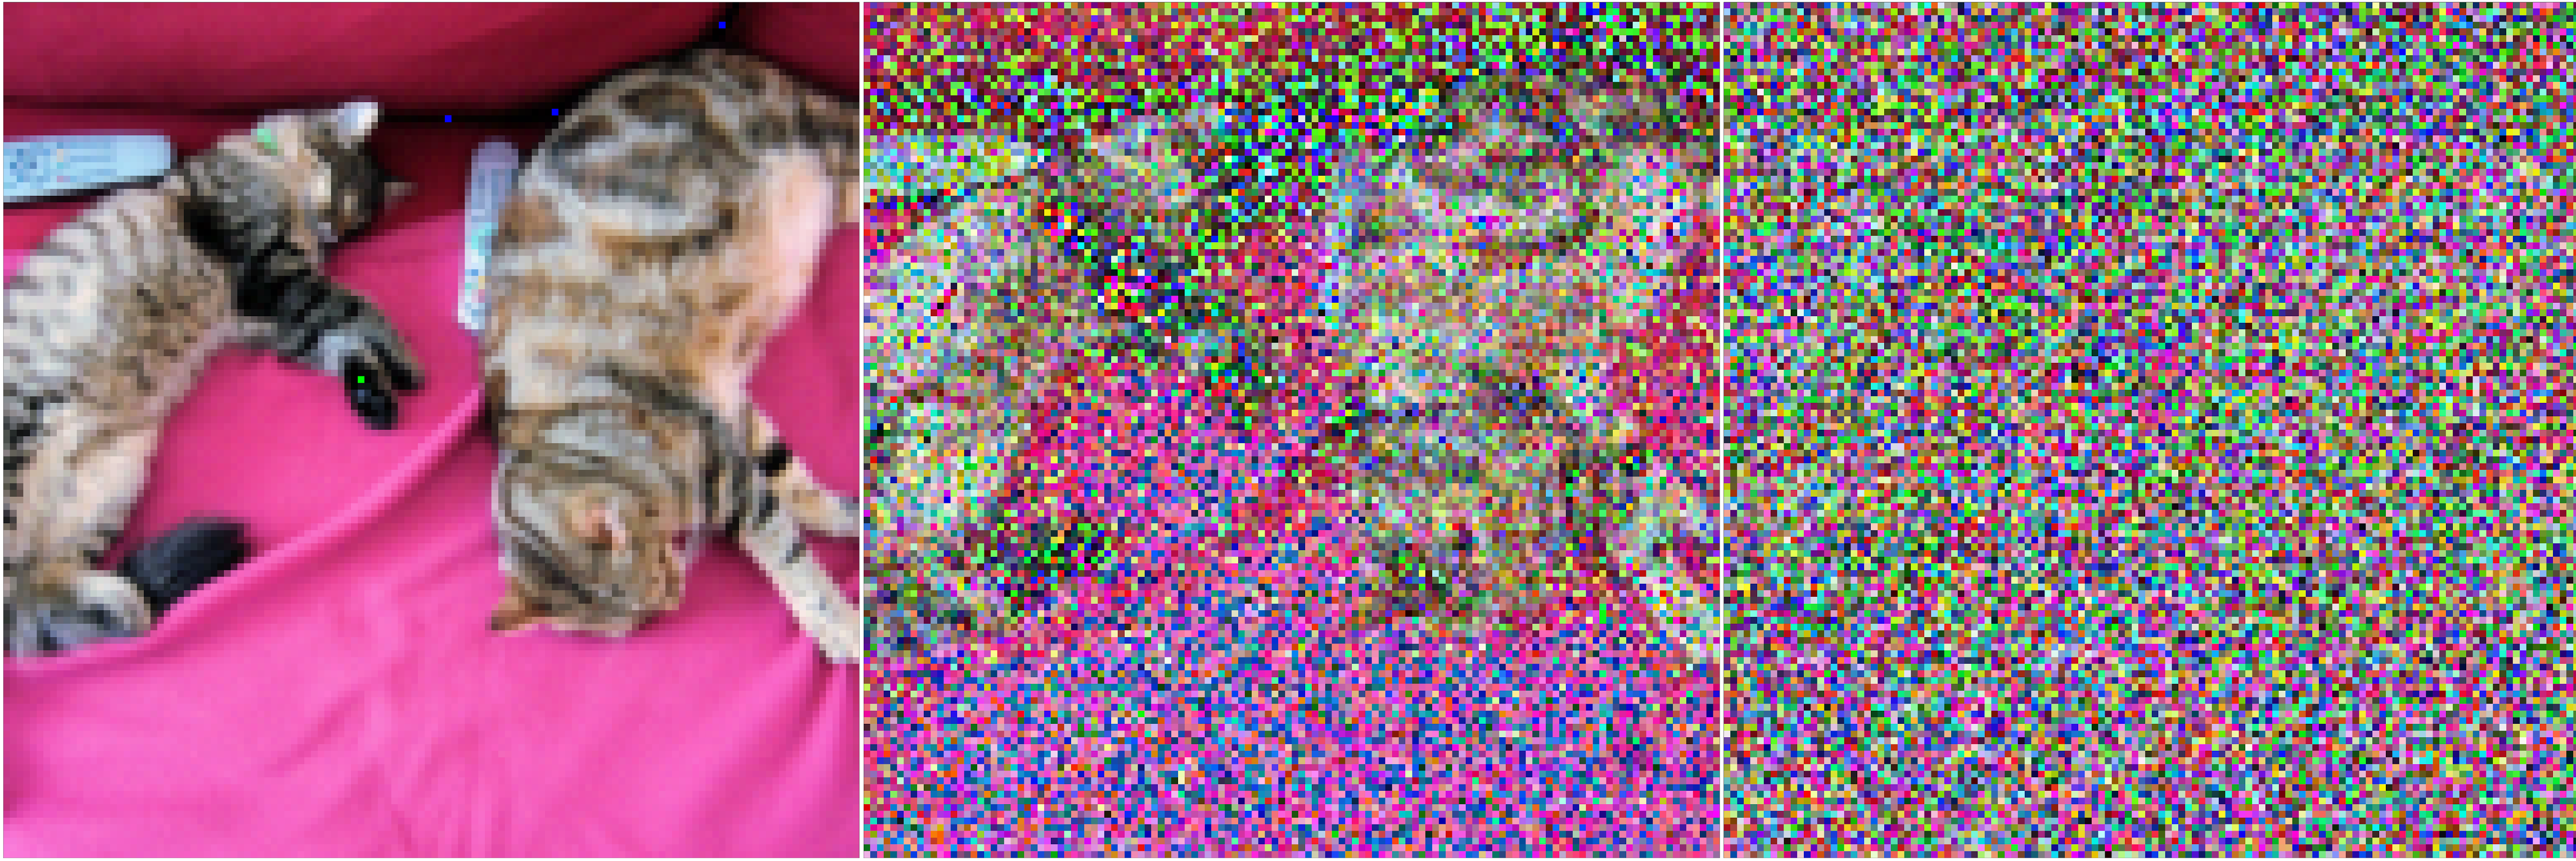
مدلهای Diffusion چیست؟
مدلهای Diffusion یا مدلهای تصادفی نوسازی، جنبهای نوین از یادگیری ماشین است که بهصورت پارادایمی گسترش میدهد: به جای تولید تصویر از صفر، یک تصویر بهصورت تدریجی تولید میشود، کد نویز در آن مخفی میشود و سپس از طریق یک شبکه عصبی عکس را برمیگردانیم.
چگونگی آموزش و نمونهگیری مدل
فرایند آموزش در این مدل شامل دو گام اصلی است: 1) تعریف تابع هدف با بازنویسی میانگین، 2) آموزش شبکه U‑Net با استفاده از مجموعه دادههای آماده در دیتاستها و لیبلهای تشخیص محتوا. سپس در هنگام نمونهگیری، با برداشتن نویز ابتدای، گام به گام، به هدف نزدیک میشویم.
- پیکربندی داده: DataLoader و پکیج torchvision
- شبکهسازی با اینترپلیشن و Group‑Normalization در U‑Net
- روشهای پیشرفتهٔ یادگیری: Parameter‑Free Training و Group‑Conditional Diffusion
برنامههای کاربردی گسترده مدل Diffusion
بهعنوان مثال، OpenAI با GLIDE، Google با ImageGen و شرکتهای آموزشی همچون Hugging Face، بهسرعت به مدلهای Diffusion متصل شدند و به نتایج با کیفیت بالا در خلق تصاویر، ویدیو و صدا دست یافتهاند. در سال ۲۰۲۲، مستندات «Annotated Diffusion» شیوهٔ کامل پیادهسازی این مدل را در PyTorch به اشتراک گذاشت و جامعهٔ علمی را برای توسعهٔ مدلهای همگرا فراهم کرد.
پرسشهای پرتکرار
مدل Diffusion به چه صورت کار میکند؟
این مدل با وارد کردن نویز به صورت تصادفی در ابتدا و سپس پیشبینی تصویر خالص از طریق شبکههای عصبی، به تدریج تصویر را بازسازی میکند. در هر گام، خطای پیشبینی کاهش مییابد تا تصویر نهایی به دست آید.
آیا مدل Diffusion فقط برای تولید تصویر است؟
نه؛ مدلهای Diffusion میتوانند برای تولید صدا، ویدیو، متن و حتی دادههای گرافیکال در زمینههای دیگر بهکار گرفته شوند، زیرا ساختار اصلی آن بهترین عملکرد را در هر حوزهٔ پیشبینی گسسته داشتهاست.


