
Optimum چیست؟
کتابخانهٔ متنباز «Optimum» از متاورس Open Source Hugging Face، بهسختیهای مقیاسپذیرترنسفورمرها میپردازد و ابزارهایی برای کمیتسازی، فشردهسازی و بهینهسازی مدل را فراهم میکند. هدف اصلی آن لزوم صرفهجویی در حافظه و سرعت اجرا بهصورت مستقیم در محیطهای تولیدی است.
چگونه میتوانیم بهصورت عملی از Optimum استفاده کنیم؟
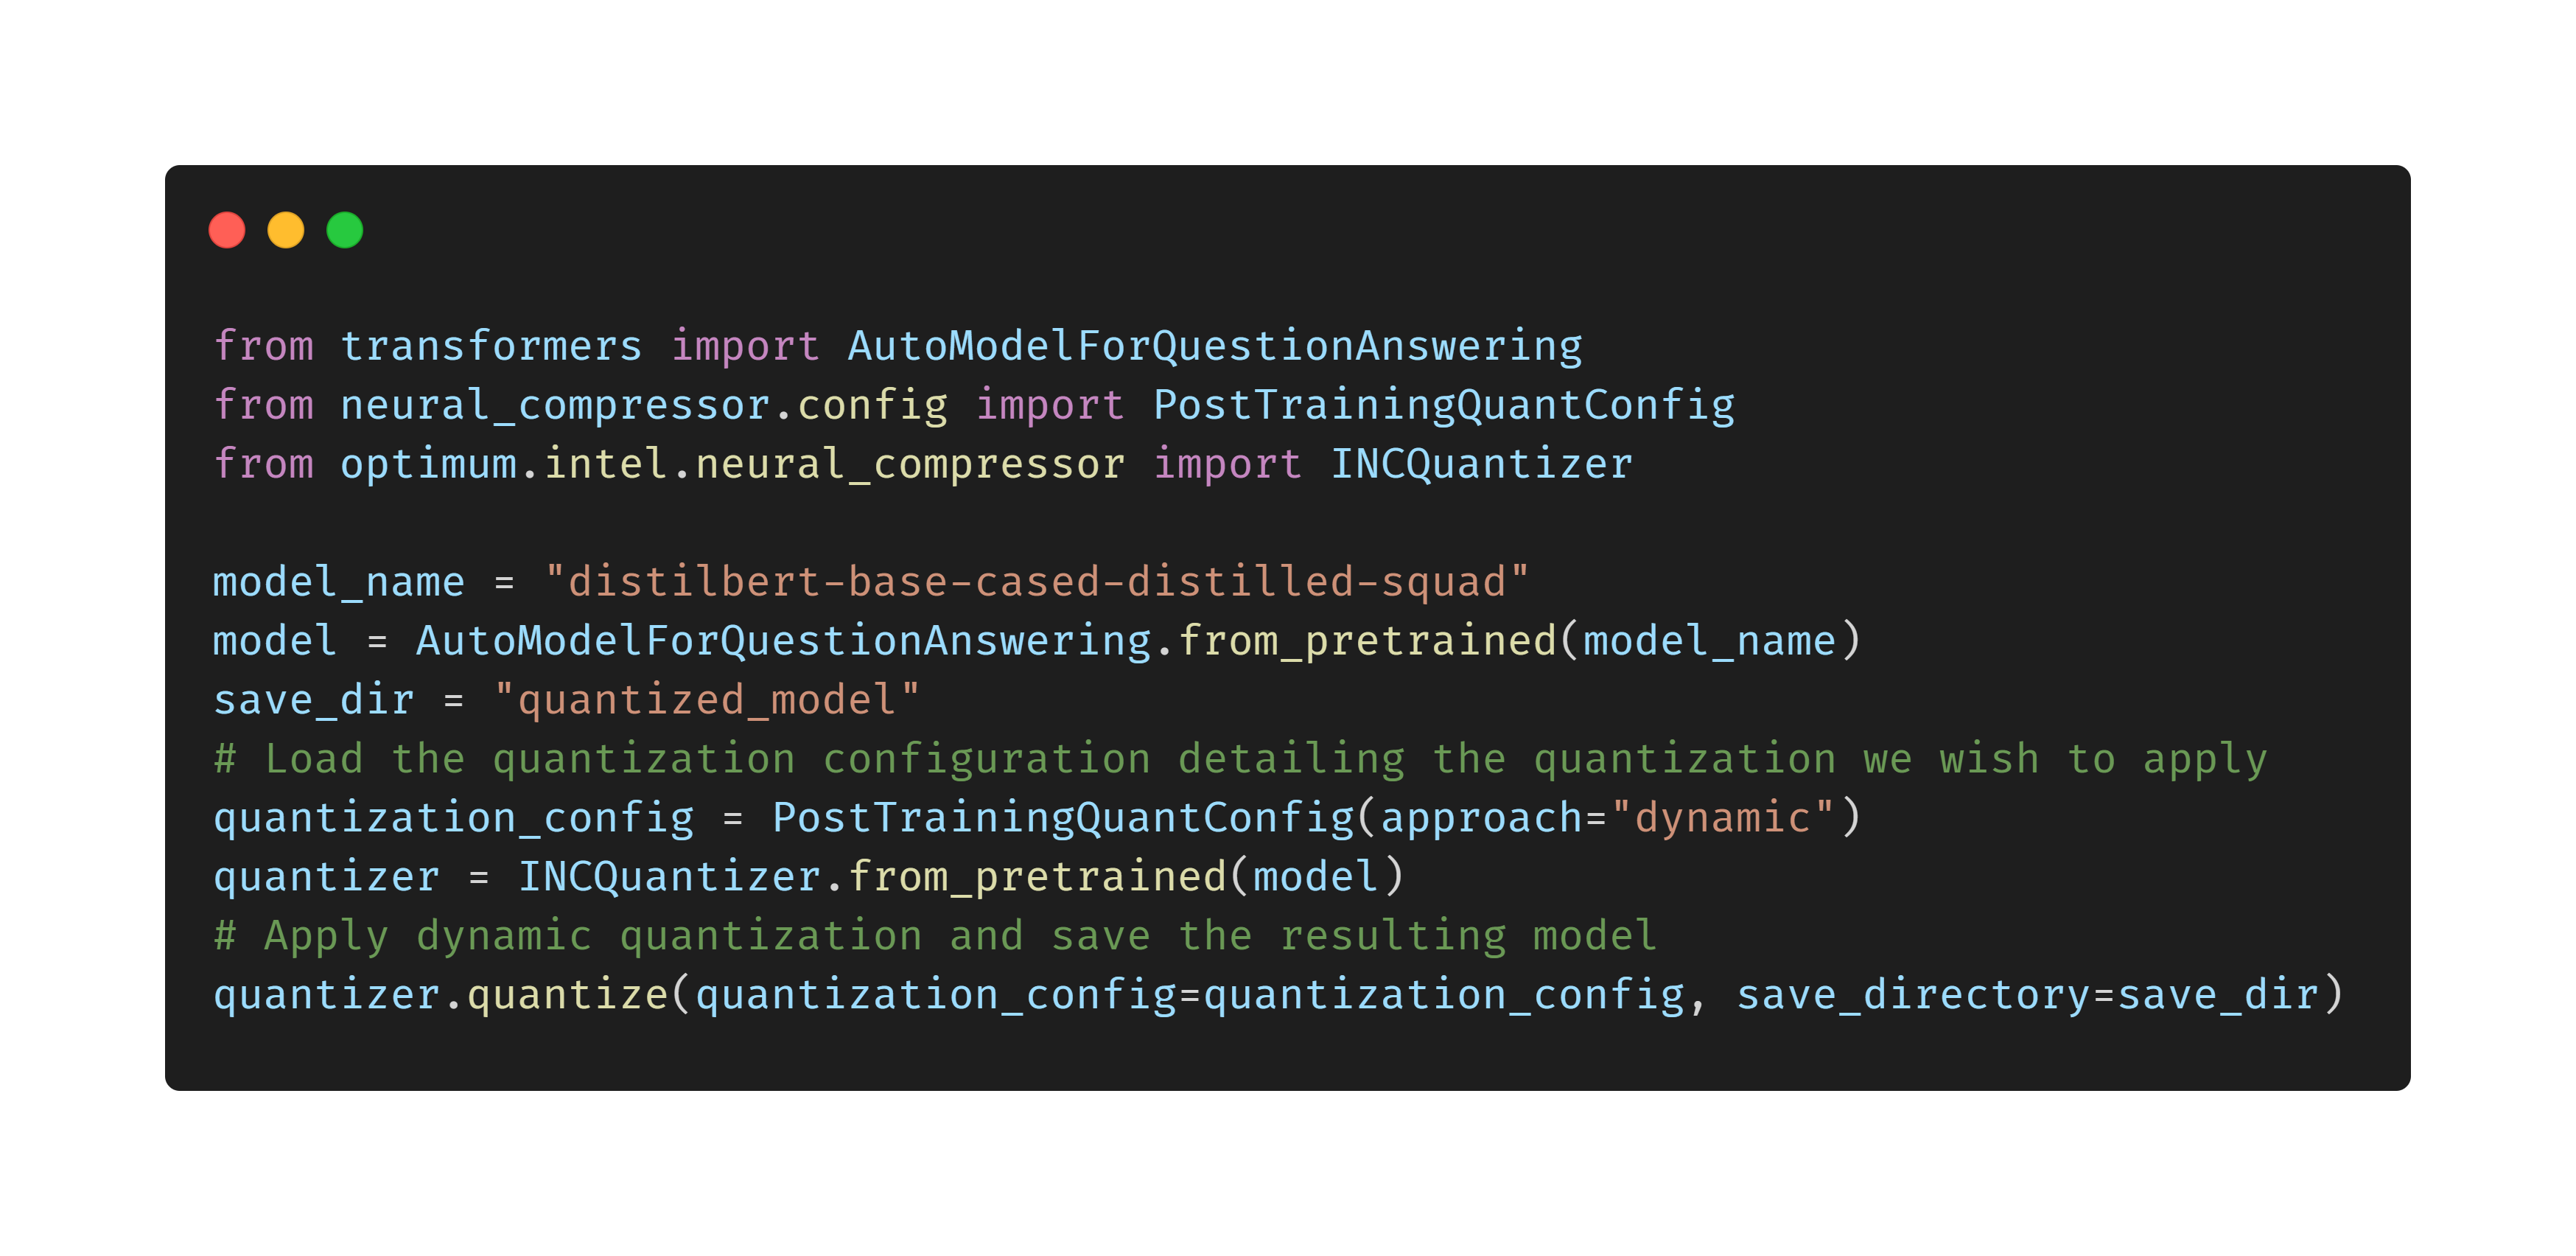
نصب کتابخانهٔ Optimum از طریق pip یا conda انجام میشود؛ سپس با تغییر پارامترها مانند quantize و compile_backend میتوان مدلها را برای پردازندههای مختلف مانند Intel Xeon یا NVIDIA GPU تهیه کرد.
پشتیبانی از سختافزارهای متعدد
Optimum طیف وسیعی از معماریهای پردازشی را پشتیبانی میکند: CPUهای Intel و AMD، GPUهای NVIDIA و همچنین اتصالات نرمافزاری برای Batch API در سرورهای ابری.
- کاهش مصرف حافظه بهطور قابلتوجه
- سرعت بالا در اجرای پیشبینیها
- پشتیبانی از مدلهای زبانی بزرگ همانند GPT و BERT با ویژگیهای کمیتسازی پیشرفته
- یکپارچگی ساده با APIهای Hugging Face و محیطهای کد باز
پرسشهای پرتکرار
Optimum با کدام سختافزارها سازگار است؟
Optimum بهصورت native با CPUهای Intel Xeon، GPUهای NVIDIA (CUDA و ROCm) و سایر پردازندههای معماریهای مختلف میتواند کار کند و بهصورت قابل تنظیم برای معماریهای خاص نیز ارائه شده است.
آیا Optimum میتواند مدلهای OpenAI مانند GPT‑3 را بهینهسازی کند؟
Optimum قابلیت کمیتسازی و فشردهسازی مدلهای زبانی بزرگ را دارد؛ اما برای استفاده از مدلهای OpenAI محدودیتهای لایسنس و دسترسی به مدل باید رعایت شود.


