معرفی Inference Endpoints
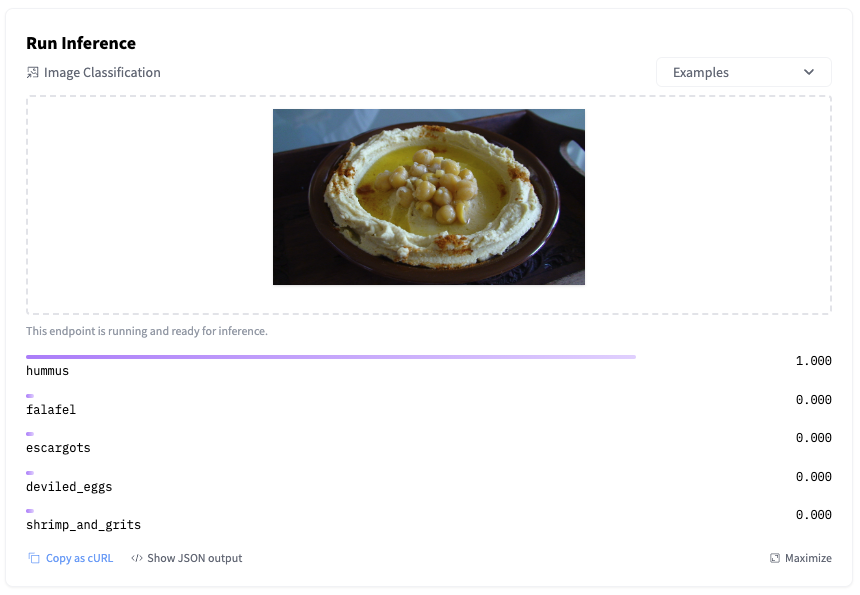
Hugging Face با ارائهٔ سرویس Inference Endpoints، مسیر توسعه و استقرار مدلهای هوش مصنوعی را به سهمرحله ساده تبدیل کرده است؛ از انتخاب مدل در مخزن، روی ابر خودتان یا سرویسهای محبوب، تا دسترسی امن و مقیاسپذیر.
چرا این سرویس ضروری است؟
استقرار مدل در محیطهای فیزیکی یا ابری اغلب نیازمند زمانبر، پیچیده و گامی است که از وظیفهٔ اصلی پژوهشسازان دور میکند. Inference Endpoints با حذف کدهای لایهٔ زیرساخت، امنیت، مانیتورینگ و مقیاسپذیری را در یک بستهٔ واحد عرضه میکند.
نحوهٔ پیادهسازی مدل در Inference Endpoints
- انتخاب مدل از Model Hub یا بارگذاری خودتان.
- انتخاب کلاود مورد علاقه: AWS, Azure، یا GCP.
- تنظیم پارامترهای امنیتی (IP, bearer token).
- یک بار کلیک بر روی Deploy و سرویس آماده به کار میشود.
- از داشبورد مرجعی برای نظارت روی استعلامها و مصرف منابع استفاده کنید.
نکتهی مهم این است که نیازی به راهاندازی container، load balancer یا scaling policy نیست؛ همه اینها توسط تیم Hugging Face انجام میشود.
پرسشهای پرتکرار
هزینهٔ استفاده از Inference Endpoints چقدر است؟
Hugging Face هزینهٔ استفاده را بر پایهٔ تعداد درخواست، مدت زمان سرور و مصرف منابع محاسبه میکند. برای اطلاعات دقیقتر میتوانید به صفحهٔ Enterprise Pricing مراجعه نمایید.
کدام دستهٔ مدلها از Inference Endpoints پشتیبانی میشوند؟
بیش از ۵۰۰۰ فریمورک و مدل شامل NLP، CV، و Audio در دسترس است؛ اما برای تضمین پشتیبانی، مدل باید از چارچوبهای PyTorch، TensorFlow یا ONNX باشد.