
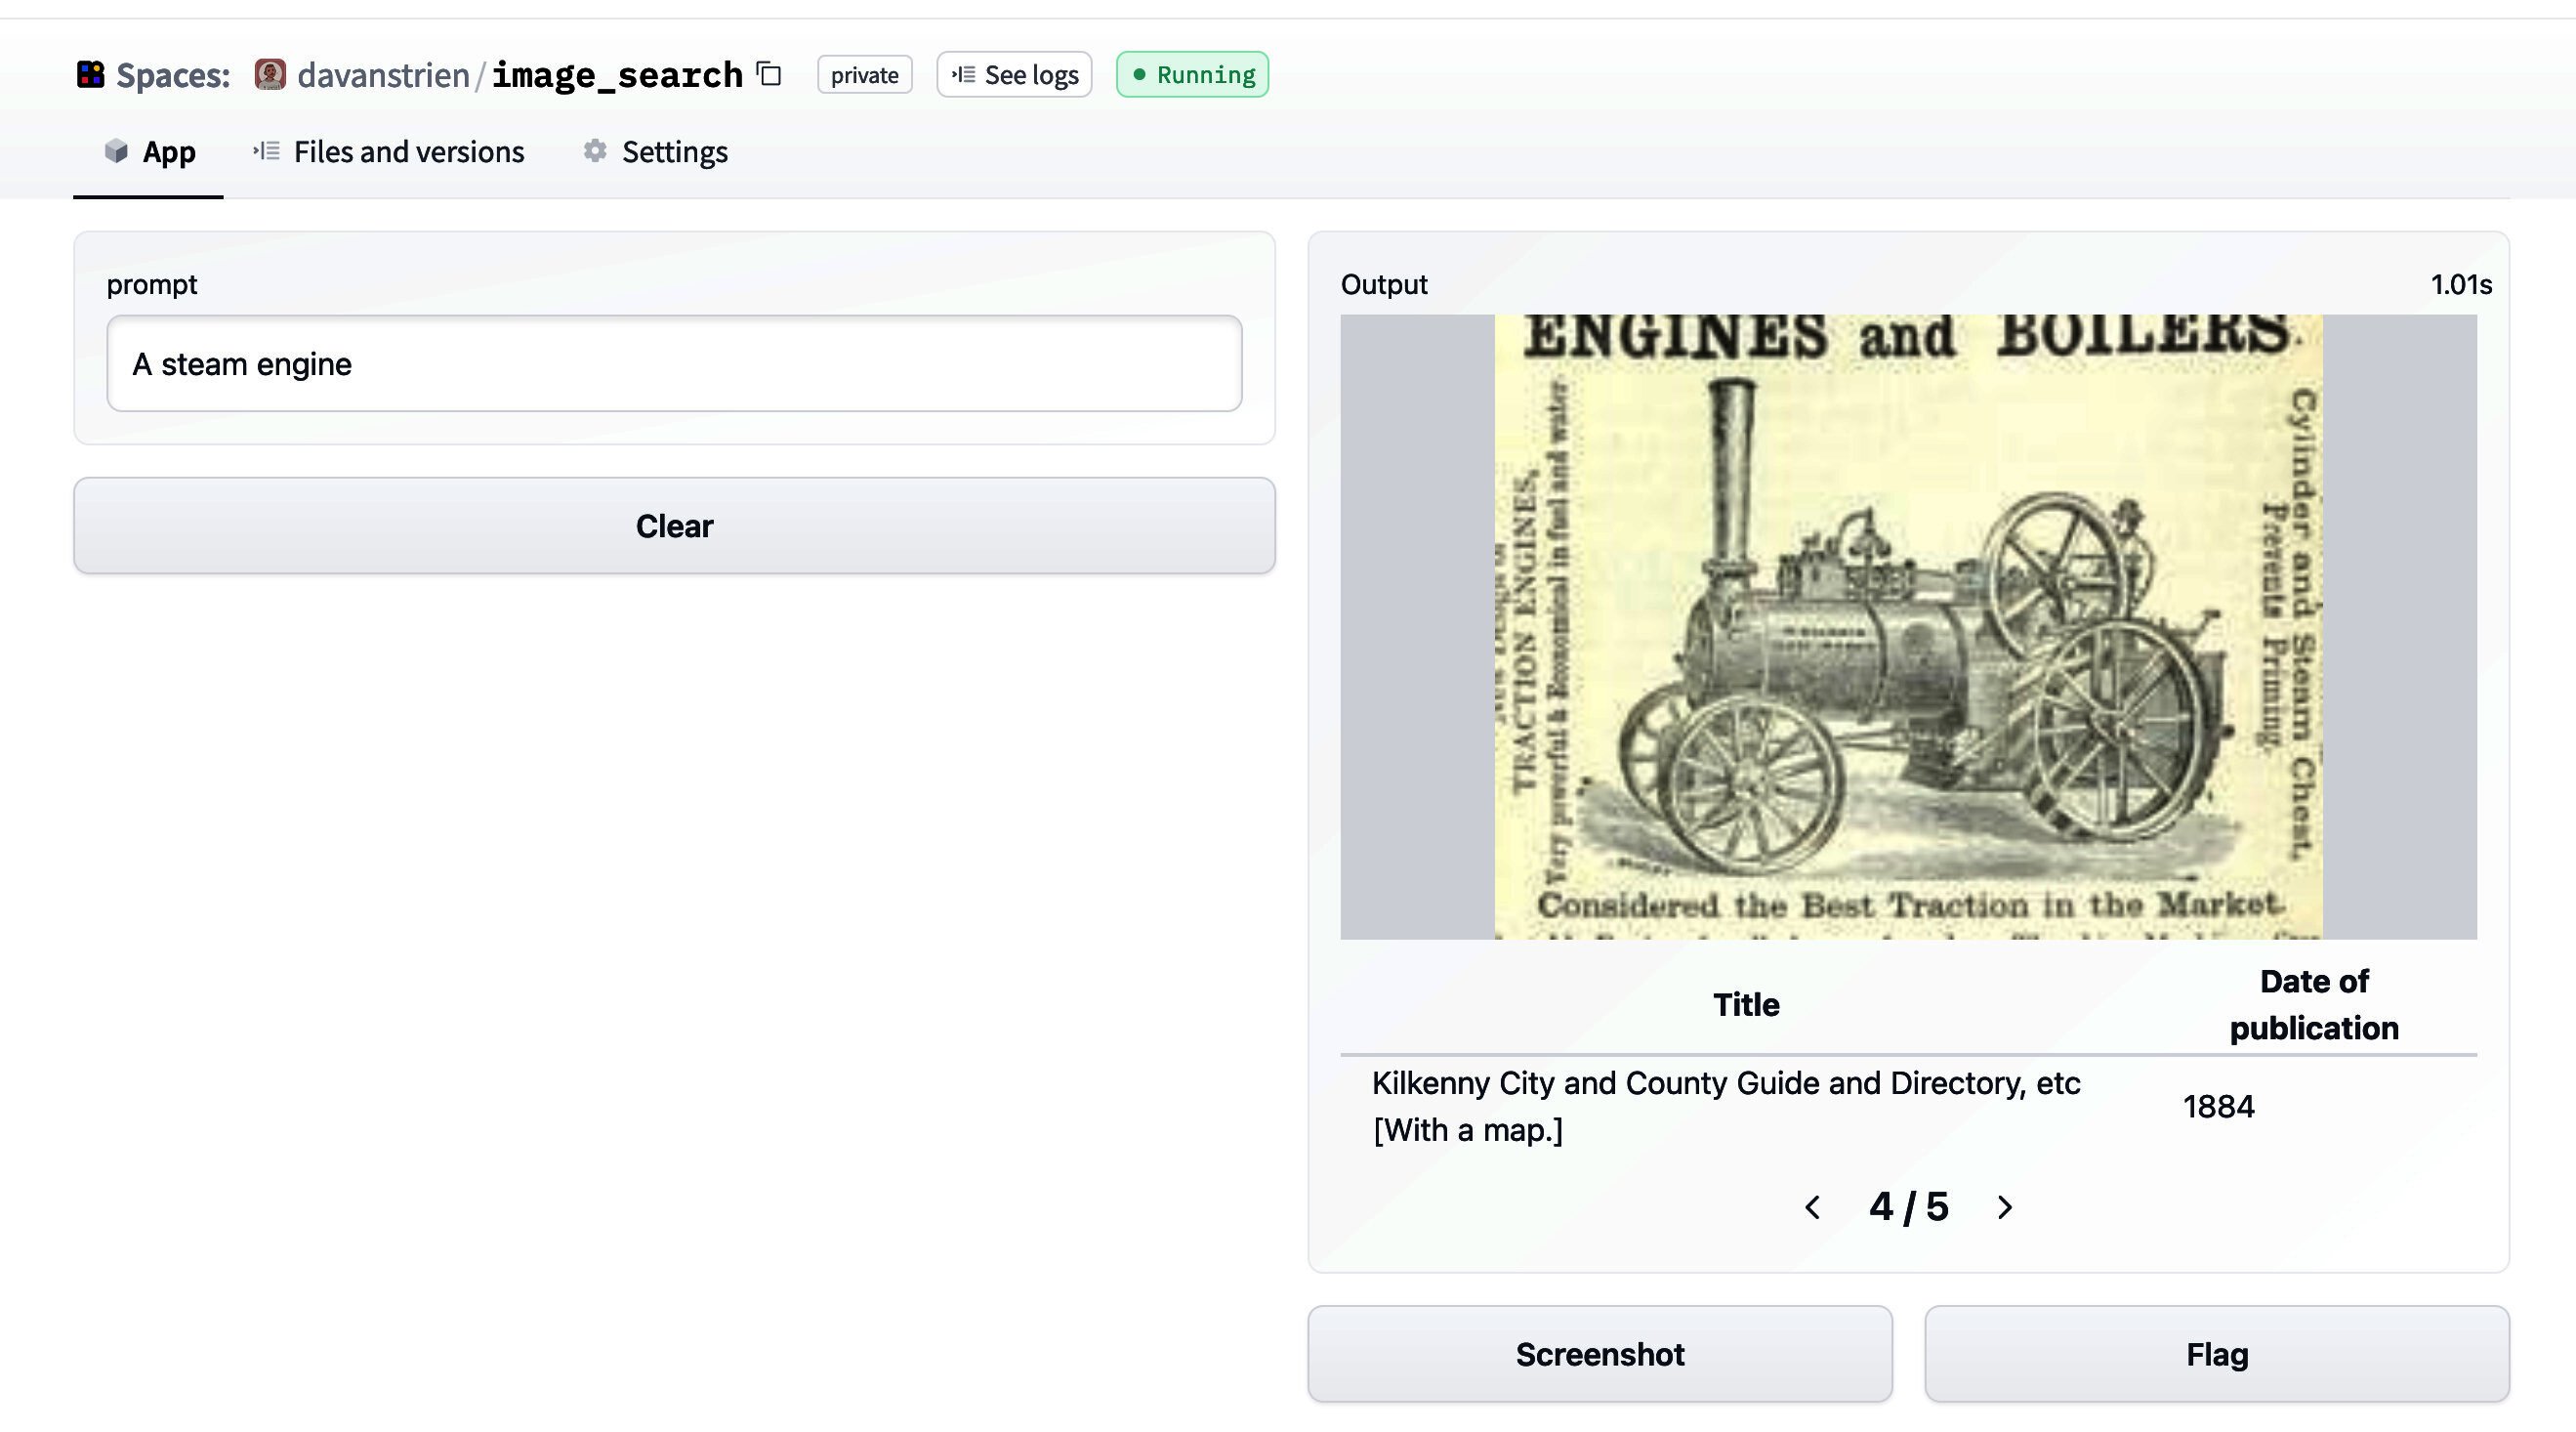
معرفی مجموعۀ دادهها
کتابخانه datasets از هیجانی قوی در تبدیل دادههای متنی به تصویری پشتیبانی میکند. یکی از نمونههای برجسته، مجموعه "Digitised Books - تصاویر تزئینی از سال ۱۵۱۰ تا ۱۹۰۰" است که امکان جستجوی تصویری در هزاران تصویر را فراهم میکند.
ابزارهای لازم برای پردازش تصویر
به منظور ساخت یک موتور جستجوی تصویر نیاز به چند کتابخانه کلیدی داریم:
- pillow – برای بارگذاری و پردازش تصاویر.
- sentence_transformers – تولید تعبیههای متنی-تصویری.
- faiss – اندیسسازی و جستجوی سریع چند بُعدی.
نصب این ابزارها با pip ساده است و پوشه بهجای حافظه قرار میگیرد تا حتی دادههای بزرگ را هم کار کند.
سازی اندیس و جستجو
خطوات اصلی شامل استخراج ویژگی تصویر، تبدیل آن به تنسور، اضافهکردن به faiss.IndexFlatL2 و سپس گرفتن پرسش به صورت متن یا تصویر. با فراخوانی المنتهای datasets میتوانی مجموعه را بالا برد و همزمان مقیاسش را حفظ کنی.
پرسشهای پرتکرار
آیا میتوانم از این نمونه کد برای تصاویر شبیهسازی شده استفاده کنم؟
بله، هر مجموعه تصویری که در قالب <code>datasets</code> دسترس داشته باشد قابل استفاده است، حتی تصاویر تولیدشده توسط مدلهای دیگر.
میتونی توضیح بدی چه تفاوتی با جستجوی تصویر سنتی دارد؟
معمولاً توصیفهای متنی را مخلوط میکند و بر پایهٔ embeddingهای یکسان برای متن و تصویر برای پیدا کردن تشابه، برخلاف الگوریتمهای صرفاً ویژگی-محور.


