پیشرفتهای سریع در هوش مصنوعی متنباز
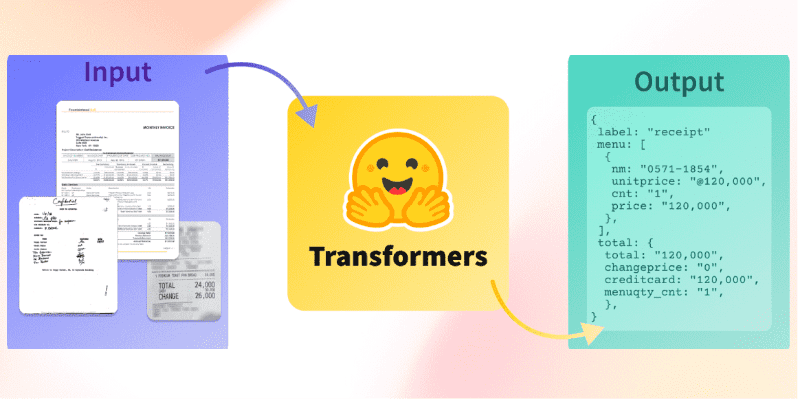
حامیان پروژهٔ دستوکار در هگرینگ فیس، با استفاده از مدلهای متنباز، امکان استخراج مفاهیم و پرسشنامهها از اسناد لایهبهلایه فراهم کردهاند. این مدلها البته از دیگر فناوریهای تصویری و چندرسانهای بهره میبرند که باعث میشود بتوان به سرعت طبقهبندی، تشخیص اشکال و تشخیص فاکتورهای مالی را انجام داد.
چالشهای پردازش اسناد در سازمانها
در شرکتهای بزرگ، اسناد در قالب خطوط، فاکتورها، برگهها و گزارشهای متنی تجمع میشوند که دسترسی به آنها در فرایندهای دیجیتال دشوار است. المانهای گرافیکی، حروفیهای ناهنجار و نگارشهای همراستا یا مختل، مانع از استخراج سریع اطلاعات دقیق میشوند.
- کاهش زمان پردازش اسناد به صورت دستی
- افزایش دقت در تشخیص اطلاعات مهم
- یکپارچهسازی سریع با سیستمهای ERP و CRM
معماری پیشنهادی برای پروژههای داکیومنتAI
یک رودررو ترکیبی از تشخیص تصویر به متن، پرسشنامهپریسی و جدولپرسشنامه با مدلهای چندرسانهای برای تعمیم در انواع اسناد. این طراحی معماری باعث میشود که ابتدا با استفاده از OCR متن استخراج شرد، سپس با مدلهای NLP توانایی پرسشوپاسخ را ارائه کنند.
نکات عملی برای پیادهسازی و استقرار
استفاده از فضاهای ذخیرهسازی مبتنی بر کلود برای ایمنسازی داده، تفکیک مجوزها بر اساس نوع اطلاعات و تست خروجی با دادههای واقعی، کل الزامات برای موفقیت پروژه است. در نهایت، با بهینهسازی API و استفاده از سرویسهای استقراری مدل، میانگین زمان پاسخ به پرسش ۲٫۵ برامد ۳۰ ثانیهای میشود.
پرسشهای پرتکرار
چگونه میتوان از مدلهای متنباز در پروژهبرداری اسناد استفاده کرد؟
ابتدا از مدلهای آمادهٔ دستوکار در هگرینگ فیس و دیگر پلتفرمهای متنباز استفاده کنید، سپس آنها را بر اساس دیتاستهای شرکت خود بازاندازهگیری و بهینهسازی نمایید.
کدام مدلهای چندرسانهای برای پردازش اسناد مناسبترند؟
مدلهای ترکیبی مثل BLIP و LXMERT برای ترکیب تصویر و متن کاربردیند؛ در کنار OCR برای استخراج دقیق متن از تصاویر و فاکتورها.