معرفی مدل Palette: هوش مصنوعی در قالب زیرساخت سازمانی
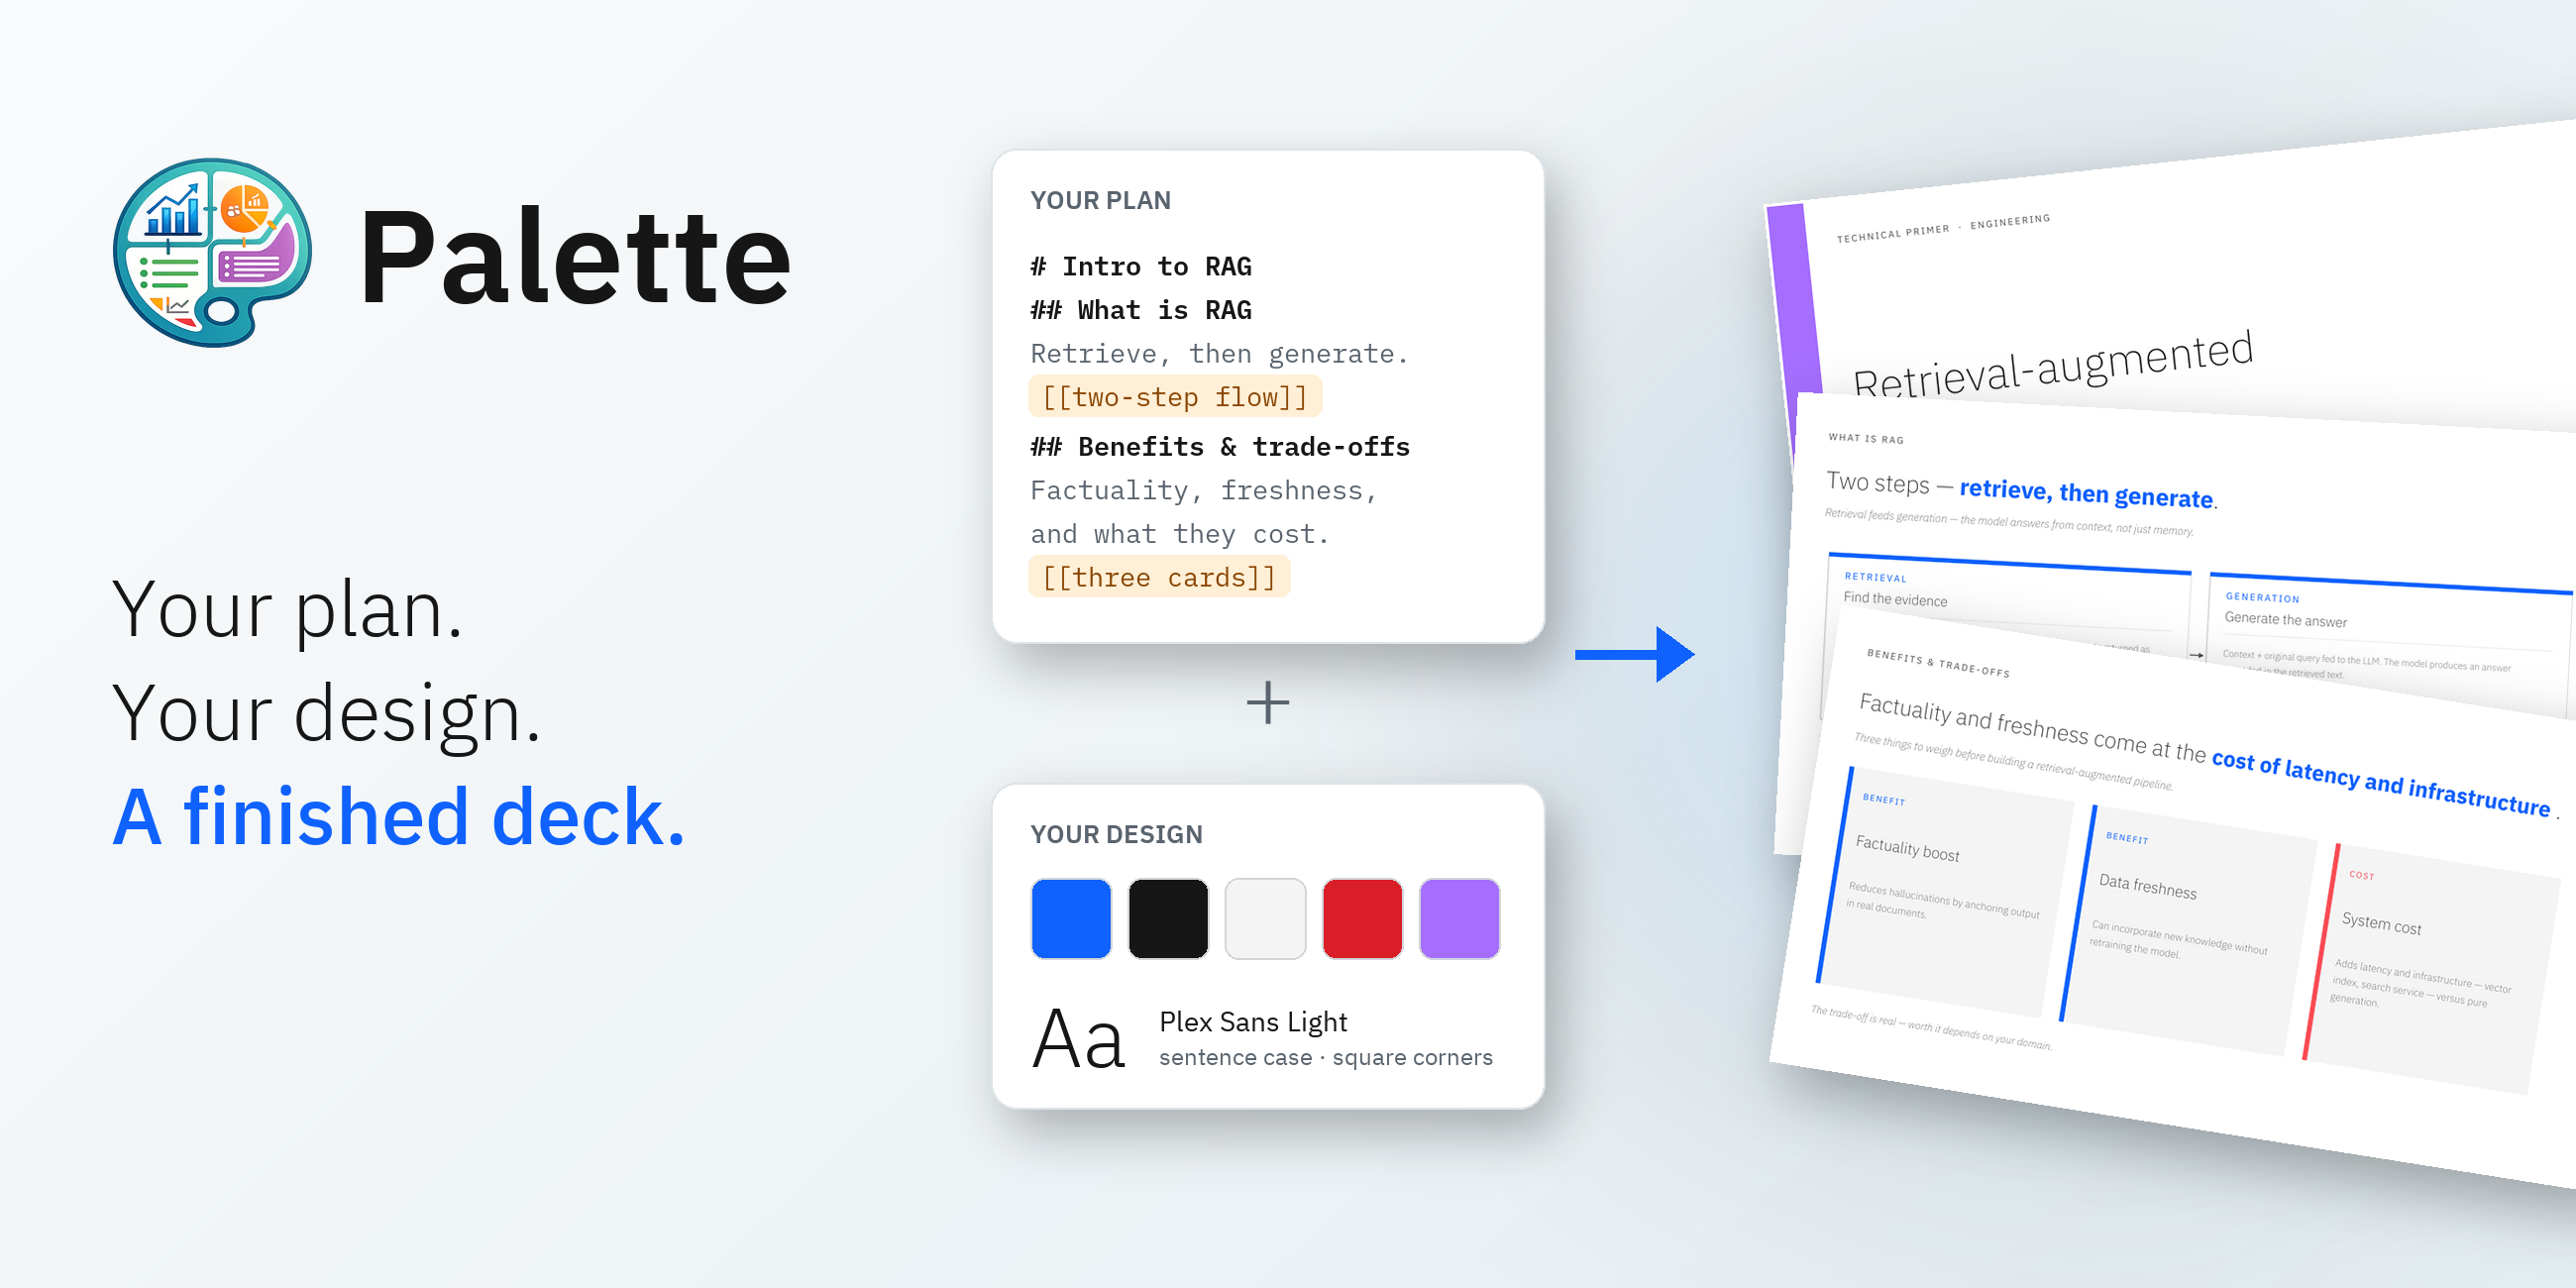
گروه پژوهشی IBM اخیراً مدلی به نام Palette را معرفی کرده است که بر مسیر خودمختاری و امنیت داده تمرکز دارد. این مدل با وزنهای باز (Open Weights) طراحی شده است تا سازمانها بتوانند آن را روی سرورهای داخلی خود اجرا کنند. این رویکرد ایمنی داده را افزایش میدهد و هزینههای اجاره زیرساخت ابری را کاهش میدهد. همچنین کنترل کاملی بر خروجیهای هوش مصنوعی حاصل میشود.
غلبه بر چالشهای فنی طراحی اسلاید
مدلهای کوچک معمولاً در ایجاد چیدمانهای بصری پیچیده دچار مشکل میشوند. این مشکلات شامل برچسبهای نامرئی، خروج متون از قاب و انباشته شدن شکلهاست. تیم IBM با استفاده از دادههای ترکیبی که بر اساس زبان طراحی IBM آموزش داده شدهاند، این محدودیتها را رفع کرده است. این روش شبیهسازی به فرآیند واقعی طراحان عمل میکند که ابتدا ساختار را مینویسند و سپس اجرا میکنند.
نتایج عملیاتی و جایگاه رقابتی مدل
ارزیابیها در بنچمارک PresentBench نشان میدهد که مدل Palette عملکردی مشابه سیستمهای فرارونده دارد. این موفقیت در دو از سه حوزه اندازهگیری شده ثبت شده است. این پیشرفت نشان میدهد که مدلهای کوچک با دادهسازی هدفمند کافی هستند. این راهکار برای شرکتهایی که دقت در بصری و برندینگ هستند، بسیار ارزشمند است.
- اجرای کاملاً محلی و بدون نیاز به اینترنت
- بهرهمندی از زبان طراحی اختصاصی سازمان
- کاهش هزینههای سرور با استفاده از مدل ۲۰ میلیاردی
پرسشهای پرتکرار
آیا مدل Palette نیاز به اتصال به اینترنت دارد؟
خیر، این مدل برای اجرا روی زیرساختهای داخلی (Self-hosted) طراحی شده است و نیازی به ارسال داده به سرورهای خارجی ندارد.
چه نوع دادههایی برای آموزش مدل Palette استفاده شده است؟
مدل با استفاده از دادههای ترکیبی (Synthetic) که بر اساس زبان طراحی IBM (IBM Design Language) تولید شدهاند، آموزش دیده است تا دقت بصری بالایی داشته باشد.