شراکت هفینگ فیس و IISc: گام نوین در هوش مصنوعی چندزبانه
در دسامبر 2025، دو سازمان پیشرو هفینگ فیس و مؤسسه علوم هند (IISc) یک توافق همکاری را برای توسعه مدلهای هوش مصنوعی در زبانهای چندگانه و خاص هند اعلام کردند. هدف این تلاش، ارتقاء دسترسی به دیتاستهای زبانی و تسهیل آموزش مدلهای محلی است.
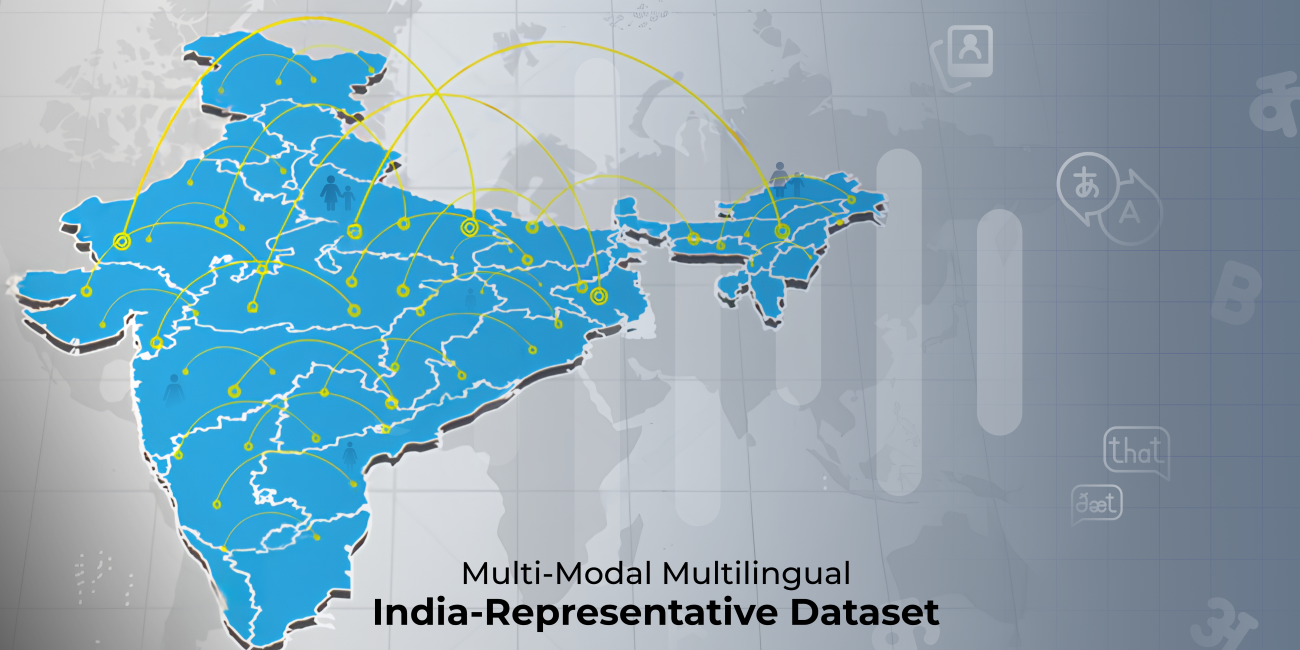
پروژه Vaani: دیتاست چندمُدال زبانهای مخفی هند
پروژه Vaani، آغازگر مجموعهای از دادههای گفتاری و متنی در ۱ میلیون نفر و ۷۷۳ حوزه مختلف است. این دیتاست بیش از ۱۵۰٬۰۰۰ ساعت گفتار و ۱۵٬۰۰۰ ساعت متن نوشتهشده را جمعآوری میکند و دهها زبان و لهجه را در بر میگیرد.
چگونه این همکاری فرصتهای توسعه را گسترش میدهد؟
به وسیله هفینگ فیس، پژوهشگران میتوانند به راحتی به این دیتاست دسترسی پیدا کنند، مدلهای خود را fine‑tune کنند و ابزارهای آماده برای پردازش صدا، ترجمه و تشخیص گفتار را به کار برند. این امکانات موجب تسهیل پژوهش و عرضه محصولات هوش مصنوعی متناسب با زبانهای محلی میشود.
- دسترسی آزاد به دیتاست برتر ۱۵۰٬۰۰۰ ساعت گفتار
- پوشش ۷۷۳ حوزه، ۱ میلیون نفر، بیش از ۱,۵۰۰ زبان و لهجه
- ابزارهای fine‑tune و پردازش صدا در هفینگ فیس هاب
پرسشهای پرتکرار
این همکاری چگونه به توسعه مدلهای هوش مصنوعی در زبانهای کمتر شناختهشده کمک میکند؟
با فراهم کردن دیتاستهای گسترده و بهروز، پژوهشگران و توسعهدهندگان امکان آموزش مدلهایی را میدهند که به طور دقیقتری لهجههای محلی و زبانهای منطقهای را درک کنند و خدمات موثری ارائه دهند.
کدام امکانات و منابع هفینگ فیس در این پروژه ارائه میشود؟
هفینگ فیس دسترسی آسان به دیتاست از طریق هاب خود، مستندسازی کامل، ابزارهای fine‑tune مدلهای NLP، پردازش صدا و چتباتهای متعدد را برای توسعهدهندگان در اختیار میگذارد.