
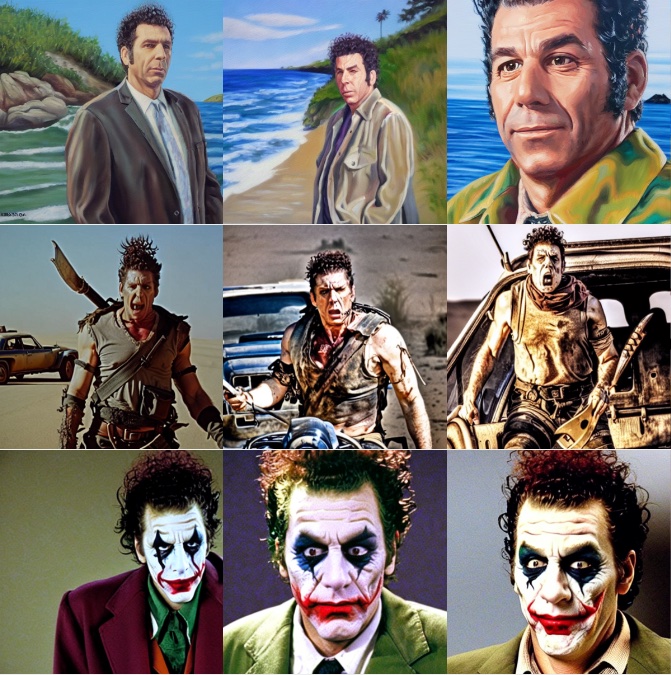
معرفی Dreambooth در Stable Diffusion
Dreambooth یک روش فاینتینینگ مخصوص است که با استفاده از تصاویر محدود، مدل Stable Diffusion را در یادگیری مفاهیم جدید آموزش میدهد. این تکنیک به تولید تصاویر شخصیسازیشده مانند اضافه کردن افراد یا سبکهای جدید کمک میکند.
بهینهسازی پارامترهای کلیدی و نتایج تجربی
تحقیقات اخیر بر روی مجموعهای از تنظیمات مثل نرخ یادگیری، تعداد ویدئوهای آموزشی، و انتخاب Scheduler تأثیر قابل توجهی بر کیفیت خروجی داشتند. گاهی تغییر کوچک در این پارامترها میتواند خروجی را به طرز چشمگیری بهبود بخشد یا به برگرفتگی (overfitting) منجر شود.
با توجه به نتایجی که در آزمایشهای متعددی حاصل شد، مهمترین نکات در جدول زیر جمعبندی شدهاند:
- نرخ یادگیری: 5e-6 تا 1e-5 برای بیشترین تعادل بین یادگیری سریع و جلوگیری از overfitting.
- مدت زمان آموزش: 200-400 گام، بسته به حجم مجموعه تصاویر.
- استفاده از Prior Preservation: به حفظ خصوصیات اصلی مدل کمک میکند.
- Scheduler: Clipped Denoising و LMS (اگر سرعت > 1) توصیه میشود.
- Fine‑tuning Encoder متغیر، مگر این که هدف خروجی خاصی نیست.
نکات کلیدی برای بهبود نتایج
1. از مجموعه تصاویر با کیفیت تصویربرداری بالا و رنگهای متنوع استفاده کنید.
2. متن توضیحی کوتاه و دقیق برای آنچه میخواهید مدل یاد بگیرد، در دیتاست قرار دهید.
3. برای جلوگیری از overfitting، از Early Stopping و تنظیم مقدار loss استفاده کنید.
4. ترکیب شدیدی از Textual Inversion و Dreambooth میتواند به بهینهسازی دادههای سبک کمک کند.
پرسشهای پرتکرار
چگونه میتوانم از Dreambooth برای ایجاد تصاویر شخصیسازیشده استفاده کنم؟
با بارگذاری چند تصویر از خودتان، تنظیمات نرخ یادگیری مناسب را انتخاب و مدل را با استفاده از اسکریپت Diffusers تمرین دهید؛ سپس از مدل فاینتینشده برای تولید تصاویر جدید بهره ببرید.
پیشنهادهای امنیتی برای استفاده از Dreambooth چیست؟
هر زمان که از Dreambooth استفاده میکنید، باید مطمئن شوید که تصاویر ورودی حاوی دارای حق نشر یا اطلاعات حساس نیستند؛ همچنین مدل نهایی را محدود به استفادههای اخلاقی مانده و از انتشار محتوای مخرب خودداری کنید.


