Vision Transformer چیست؟
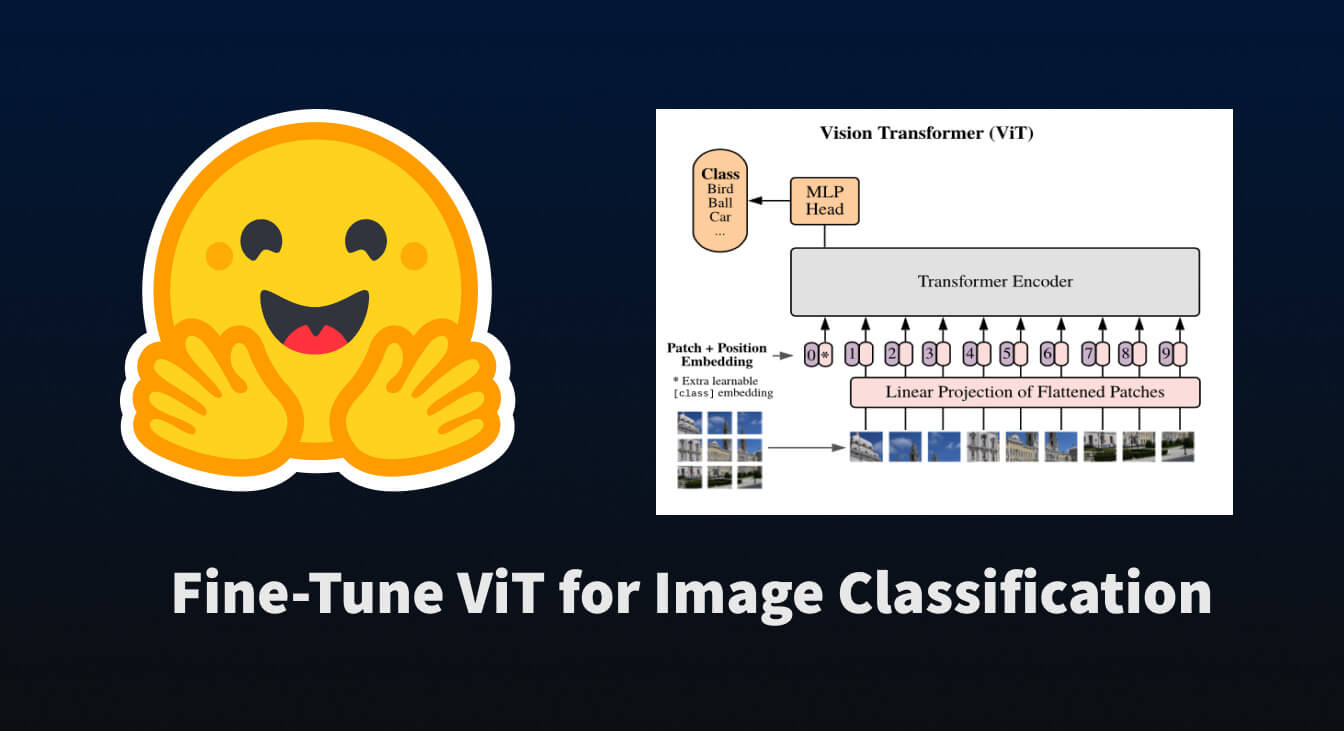
Vision Transformer (ViT) یک معماری مبتنی بر Transformer برای پردازش تصویر است که در ژوئن ۲۰۲۱ توسط تیم Google Brain معرفی شد. این مدل تصاویر را به توکنهای همانند توکنهای متن تبدیل میکند و سپس آنها را وارد شبکه رسیدگی به توجه میکند.
مراحل بارگیری و پیشپردازش دادهها
در این بخش بهصورت خلاصه روند انتخاب فایل، دانلود و پردازش مجموعه دادههای تصویر آورده شده است. ابتدا ازون دیتاستهای موجود در 🤗 datasets استفاده میکنیم، سپس کلاس پیشپردازنده ImageProcessor را برای بعدیسازی تصویر و نرمالسازی مقادیر فراخوانی میکنیم.
- دریافت دیتاست پشتیبانی از datasets.load_dataset().
- ایجاد transform برای تبدیل تصویر به توکن و مقیاس.
- تعریف data_collator برای تکهبندی پایتون و حداکثر کردن کارایی GPU.
آموزش و ارزیابی مدل ViT
پس از بازسازی دادهها، مدل پیشآموزش شده ViT را از 🤗 transformers بارگذاری میکنیم. سپس از Trainer برای آموزش بهصورت متوازن با استفاده از فنون انتخابشده مثل LR Scheduler و Weight Decay بهره میبریم. در پایان، compute_metrics برای محاسبه دقت و معیارهای دیگر به کار میرود.
نتیجهگیری و بهترین روشها
نتایج نشان میدهد که با تنظیم نهایی ViT، میتوان دقت بالایی در دستهبندی تصاویر بهدست آورد؛ بهویژه در مجموعه دادههای کم حجم که روشهای یادگیری انتقالی بهرده افزونه تعین میکنند.
پرسشهای پرتکرار
چرا ViT به جای CNNها مفید است؟
ViT با استفاده از مکانیسم توجه، الگوهای پیچیدهتری در تصویر شناسایی میکند و در مقایسه با CNNها معمولا به دادههای بزرگتری نیاز دارد.
آیا میتوان مدل ViT را در دستگاههای کوچک اجرا کرد؟
بله، با استفاده از مدلهای کوچکتر مانند ViT‑S یا با فشردهسازی کد، میتوان آن را بر روی دستگاههای محدود حافظه اجرا کرد.