آینده تشخیص گفتار چندزبانه در دستان هوش مصنوعی
در دنیای امروز که ارتباطات مرز نمیشناسد، نیاز به سیستمهای تشخیص گفتار خودکار (ASR) که قادر به پردازش زبانهای متعدد باشند، بیش از پیش احساس میشود. با این حال، توسعه مدلهای کارآمد برای زبانهایی با منابع داده کم، همواره یک چالش بزرگ بوده است. اما اکنون، با نوآوریهای اخیر در حوزه هوش مصنوعی و مدل «Massive Multilingual Speech (MMS)» از Meta AI، این چشمانداز دستخوش تحولی عظیم شده است.
Hugging Face، پیشگام در دسترسسازی هوش مصنوعی متنباز، به تازگی نحوه استفاده از آداپتورهای MMS را برای رسیدن به دقت بینظیر در ASR چندزبانه، به ویژه برای زبانهای کممنبع، نمایش داده است. این رویکرد نه تنها مرزهای توانایی هوش مصنوعی را جابجا میکند، بلکه با دموکراتیزه کردن دسترسی به این فناوری، گامی بزرگ در جهت فراگیرسازی هوش مصنوعی برداشته است.
پیشرفتهای شگفتانگیز در تشخیص گفتار: از Wav2Vec2 تا MMS
سفر هوش مصنوعی در تشخیص گفتار از مدلهای پیشگامی چون Wav2Vec2 آغاز شد که در سال ۲۰۲۰ توسط فیسبوک (اکنون متا) منتشر شد و عملکرد چشمگیری در تشخیص گفتار انگلیسی نشان داد. به دنبال آن، نسخههای چندزبانه مانند XLSR و XLM-R معرفی شدند که قادر به شناسایی گفتار در ۱۲۸ زبان بودند. این مدلها با یادگیری نمایشهای گفتاری که در چندین زبان مفید بودند، قدم بزرگی برداشتند.
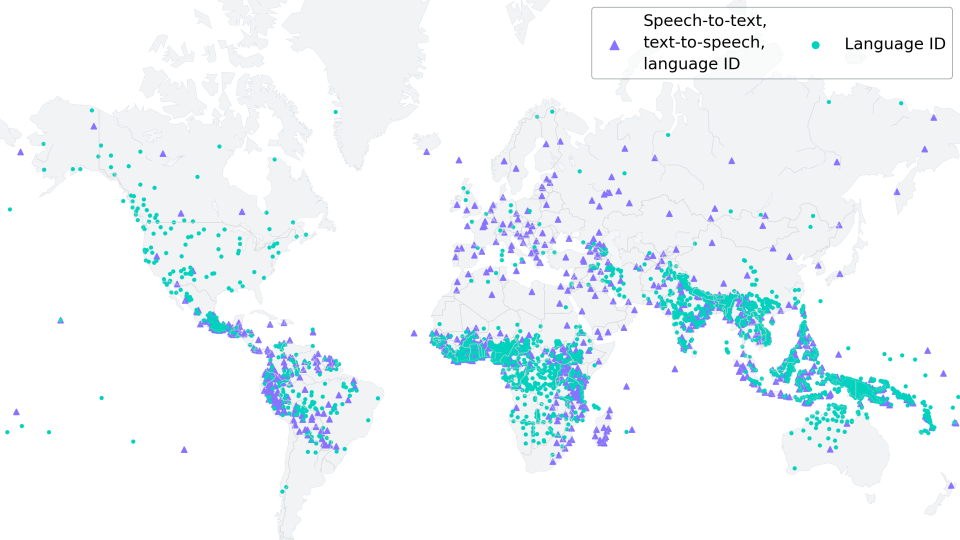
اما نقطه اوج این پیشرفتها، معرفی مدل MMS توسط Meta AI است. MMS با پشتیبانی از بیش از ۱۱۰۰ زبان گفتاری، مفهوم «نمایشهای گفتار چندزبانه» را به سطح کاملاً جدیدی ارتقا میدهد. این مدل نه تنها قادر به شناسایی و رونویسی گفتار است، بلکه با نقاط بازرسی (checkpoints) متنوعی که منتشر کرده، قابلیت تشخیص زبان و تبدیل متن به گفتار را نیز ارائه میدهد. این گستره بینظیر، MMS را به یک ابزار بیرقیب در حوزه پردازش گفتار جهانی تبدیل میکند.
تکنیک آموزش تطبیقی (Adapter Training) و سرعت بینظیر
یکی از دلایل اصلی موفقیت خیرهکننده MMS، استفاده از تکنیک آموزش تطبیقی (Adapter Training) است. این روش نوآورانه، امکان فاینتیونینگ مدلهای بزرگ را با حداقل منابع و در کوتاهترین زمان ممکن فراهم میآورد. به گفته Hugging Face، با استفاده از آداپتورهای MMS، میتوان تنها با ۱۰ تا ۲۰ دقیقه فاینتیونینگ، به نرخ خطای واژهای (Word Error Rate) به طرز شگفتآوری پایین دست یافت. این ویژگی به ویژه برای زبانهایی که دادههای آموزشی کمی دارند، انقلابی محسوب میشود.
مزایای اصلی آموزش تطبیقی عبارتند از:
- کارایی بالا: کاهش چشمگیر زمان و منابع محاسباتی مورد نیاز برای آموزش.
- دقت بیسابقه: دستیابی به نرخ خطای واژهای پایین، حتی برای زبانهای کممنبع.
- انعطافپذیری: قابلیت تطبیق مدلهای پایه قدرتمند با وظایف و زبانهای جدید بدون نیاز به بازآموزی کامل.
- دسترسیپذیری: دموکراتیزه کردن فناوری پیشرفته ASR برای جوامع و زبانهای مختلف.
این رویکرد، نه تنها به محققان و توسعهدهندگان اجازه میدهد تا به سرعت مدلهای سفارشیشده بسازند، بلکه موانع ورود به حوزه پردازش گفتار چندزبانه را نیز به شدت کاهش میدهد.
آینده هوش مصنوعی و فراگیرسازی دسترسی به زبان
دستاورد مدل MMS و رویکرد آموزش تطبیقی آن، فراتر از یک پیشرفت تکنولوژیکی صرف است. این پیشرفت، به معنی توانمندسازی جوامع زبانی کوچک و فراهم آوردن امکان دسترسی آنها به فناوریهای پیشرفته هوش مصنوعی است. با پشتیبانی از بیش از ۱۱۰۰ زبان، MMS میتواند به حفظ و ترویج تنوع زبانی کمک کند و پلی ارتباطی بین فرهنگها و جوامع مختلف ایجاد نماید. این گامی بزرگ در راستای چشمانداز Hugging Face برای «پیشبرد و دموکراتیزه کردن هوش مصنوعی از طریق متنباز و علم باز» است.
پرسشهای پرتکرار
MMS چیست و چه تفاوتی با مدلهای قبلی دارد؟
مدل Massive Multilingual Speech (MMS) توسعه یافته توسط Meta AI است که قابلیت شناسایی، رونویسی و تولید گفتار را در بیش از ۱۱۰۰ زبان دارد. تفاوت اصلی آن در مقیاسپذیری بینظیر و تکنیک آموزش تطبیقی است که به سرعت نرخ خطای واژهای را کاهش میدهد، در حالی که مدلهای قبلی مانند Wav2Vec2 یا XLSR/XLM-R تعداد زبانهای کمتری را پوشش میدادند و به این سرعت آموزشپذیری بالا برای زبانهای کممنبع دست نمییافتند.
آموزش تطبیقی (Adapter Training) چه مزایایی دارد؟
آموزش تطبیقی امکان "فاینتیون" سریع و موثر مدلهای بزرگ را فراهم میکند. مزیت اصلی آن کاهش چشمگیر زمان و منابع مورد نیاز برای آموزش است؛ به طوری که در مدل MMS، تنها با ۱۰ تا ۲۰ دقیقه فاینتیونینگ، نرخ خطای واژهای به میزان قابل توجهی پایین میآید، خصوصاً برای زبانهایی که منابع داده کمی دارند. این روش همچنین باعث میشود مدل پایه اصلی دستنخورده باقی بماند و فقط لایههای کوچک "آداپتور" تغییر کنند.