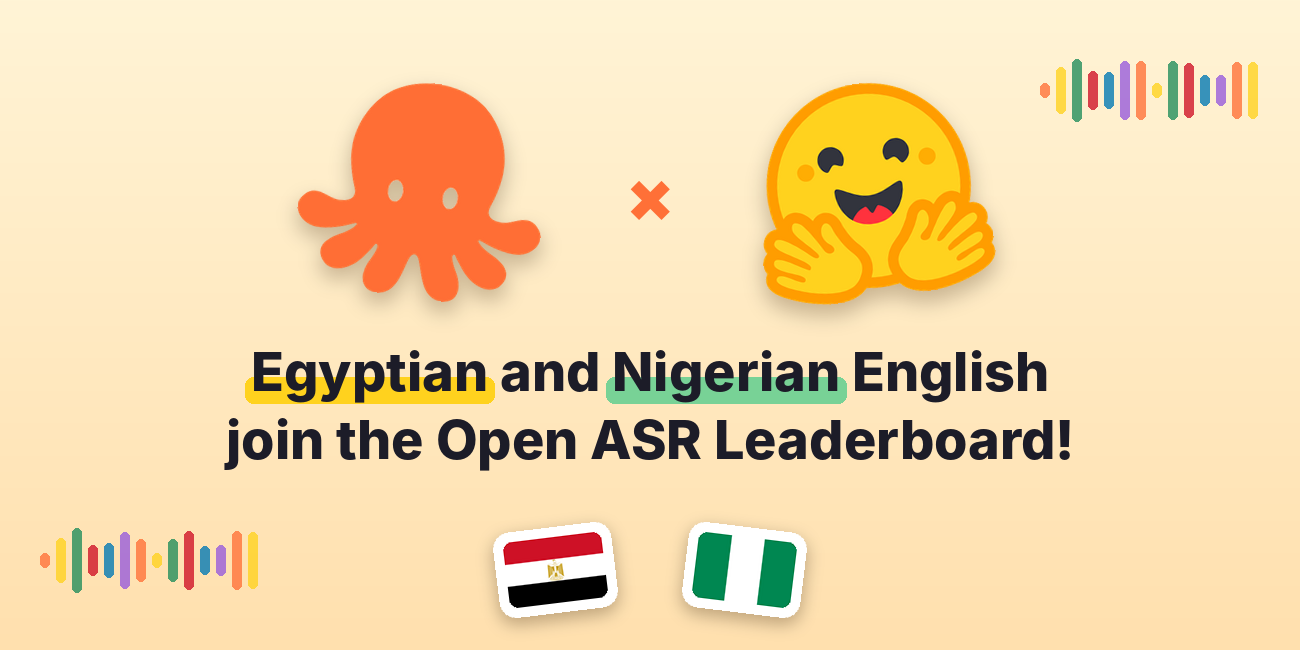
در گامی مهم برای democratization (دموکراتیزه کردن) هوش مصنوعی، Hugging Face اعلام کرد که دو لهجه جدید به مجموعه دادههای ارزیابیاش برای مدلهای تشخیص گفتار (ASR) اضافه شده است. این توسعه شامل دادههای خصوصی مربوط به انگلیسی با لهجه مصری و نیجریهای است که از همکاری نزدیک با شرکت Liva AI حاصل شده است.
ارتقاء دقت ارزیابی مدلهای گفتار
هدف اصلی این پروژه، غنیسازی تنوع ازادی (accents) و زبانها در ارزیابیهای ASR است. تاکنون دادههایی از لهجههای مختلف از جمله هندی وجود داشت، اما افزودن این دو لهجه جدید، نمای کلیتری از عملکرد مدلها در مواجهه با تنوعهای جهانی فراهم میکند. این کار به جامعه محققان کمک میکند تا عملکرد واقعی مدلها در شرایط واقعیتر و نه صرفاً بر روی دادههای پرکاربردها (benchmaxxing) بسنجند.
استفاده از چارچوب سه حلقه کاکرو
برای ارائه تحلیلی دقیقتر، از چارچوب "سه حلقه کاکرو" (Kachru’s Three Circles) استفاده شده است. این روش به تقسیمبندی و دستهبندی بهتر لهجهها بر اساس پیوندهای تاریخی و زبانی با انگلیسی استاندارد کمک میکند. این رویکرد باعث شده تا در تب خصوصی Borda، شکستهای (breakdown) لهجهای دقیقتر و قابل اعتمادتری ارائه شود.
- افزودن دادههای خصوصی برای کاهش نگرانی از یادگیری بیش از حد بر روی دادههای تست
- همکاری با چندین ارائهدهنده داده مانند Appen, DataOceanAI و Voice Arena
- توجه ویژه به لهجههای غیرسنجاقیتر و متنوعتر در سراسر جهان
- ارتقاء اعتماد جامعه به نتایج ارزیابیهای باز و شفاف
تأثیر بر آینده فناوریهای گفتاری
این گام نهتنها کیفیت مدلهای پردازش زبان طبیعی را بهبود میبخشد، بلکه گامی به سوی عدالت الگوریتمیک برداشته است تا کاربرانی با لهجههای مختلف از عملکرد یکنواخت و دقیقتر نرمافزارها بهرهمند شوند.
پرسشهای پرتکرار
چرا دادههای خصوصی برای ارزیابی ASR مهم هستند؟
دادههای خصوصی از پدیده benchmaxxing (بهینهسازی مدل صرفاً بر روی دادههای تست شناخته شده) جلوگیری میکنند و اطمینان میدهند که مدلها واقعاً توانایی تعمیمپذیری به دادههای جدید و تنوع خُلق (natural variations) را دارند.
الگوریتم کاکرو سه حلقه چیست و چگونه در این پروژه استفاده شده؟
چارچوب کاکرو، انگلیسی را بر اساس پیوندهای تاریخی و فرهنگی به سه حلقه تقسیم میکند. در این پروژه از این ساختار برای طبقهبندی دقیقتر لهجهها و ارائه تحلیلهای بهتر از عملکرد مدلها بر اساس ریشههای زبانی آنها استفاده شده است.