بسیاری از متخصصان یادگیری ماشین حسی نسبت به سریعتر اجرا کردن مدلها دارند، اما شمار کمتری میدانند چگونه عندی پیدا کنند که چرا یک مدل کند اجرا میشود. آمازون در اولین قسمت از سری مقالات «پروفایلکردن TorchNeuron»، روشی نظاممند برای تحلیل کارایی استنتاج و شناسایی گلوگاههای زمانی ارائه داده است.
این مطلب از سطح صفر شروع میکند و هیچ پیشزمینهای در استفاده از ابزارهای پروفایل لازم ندارد. این آموزش روی AWS Trainium — تراشه اختصاصی هوش مصنوعی آمازون برای بارهای کاری آموزش و استنتاج — و TorchNeuron، بکاند بومی متنباز PyTorch آن، اجرا میشود.
Neuron بهعنوان بکاند PyTorch
TorchNeuron جریانهای کاری استاندارد PyTorch را روی تراشه Trainium پشتیبانی میکند؛ از اجرای eager و torch.compile گرفته تا APIهای رایج پایتورچ، همه با حداقل تغییر در کد اجرا میشوند. علاوه بر این، TorchNeuron با Neuron Kernel Interface (NKI) یکپارچه شده تا اپراتورهای سفارشی و بهینهسازیهای کارایی ویژه سختافزار Trainium ممکن شود.
راهاندازی ابزار پروفایلکردن: Neuron Explorer
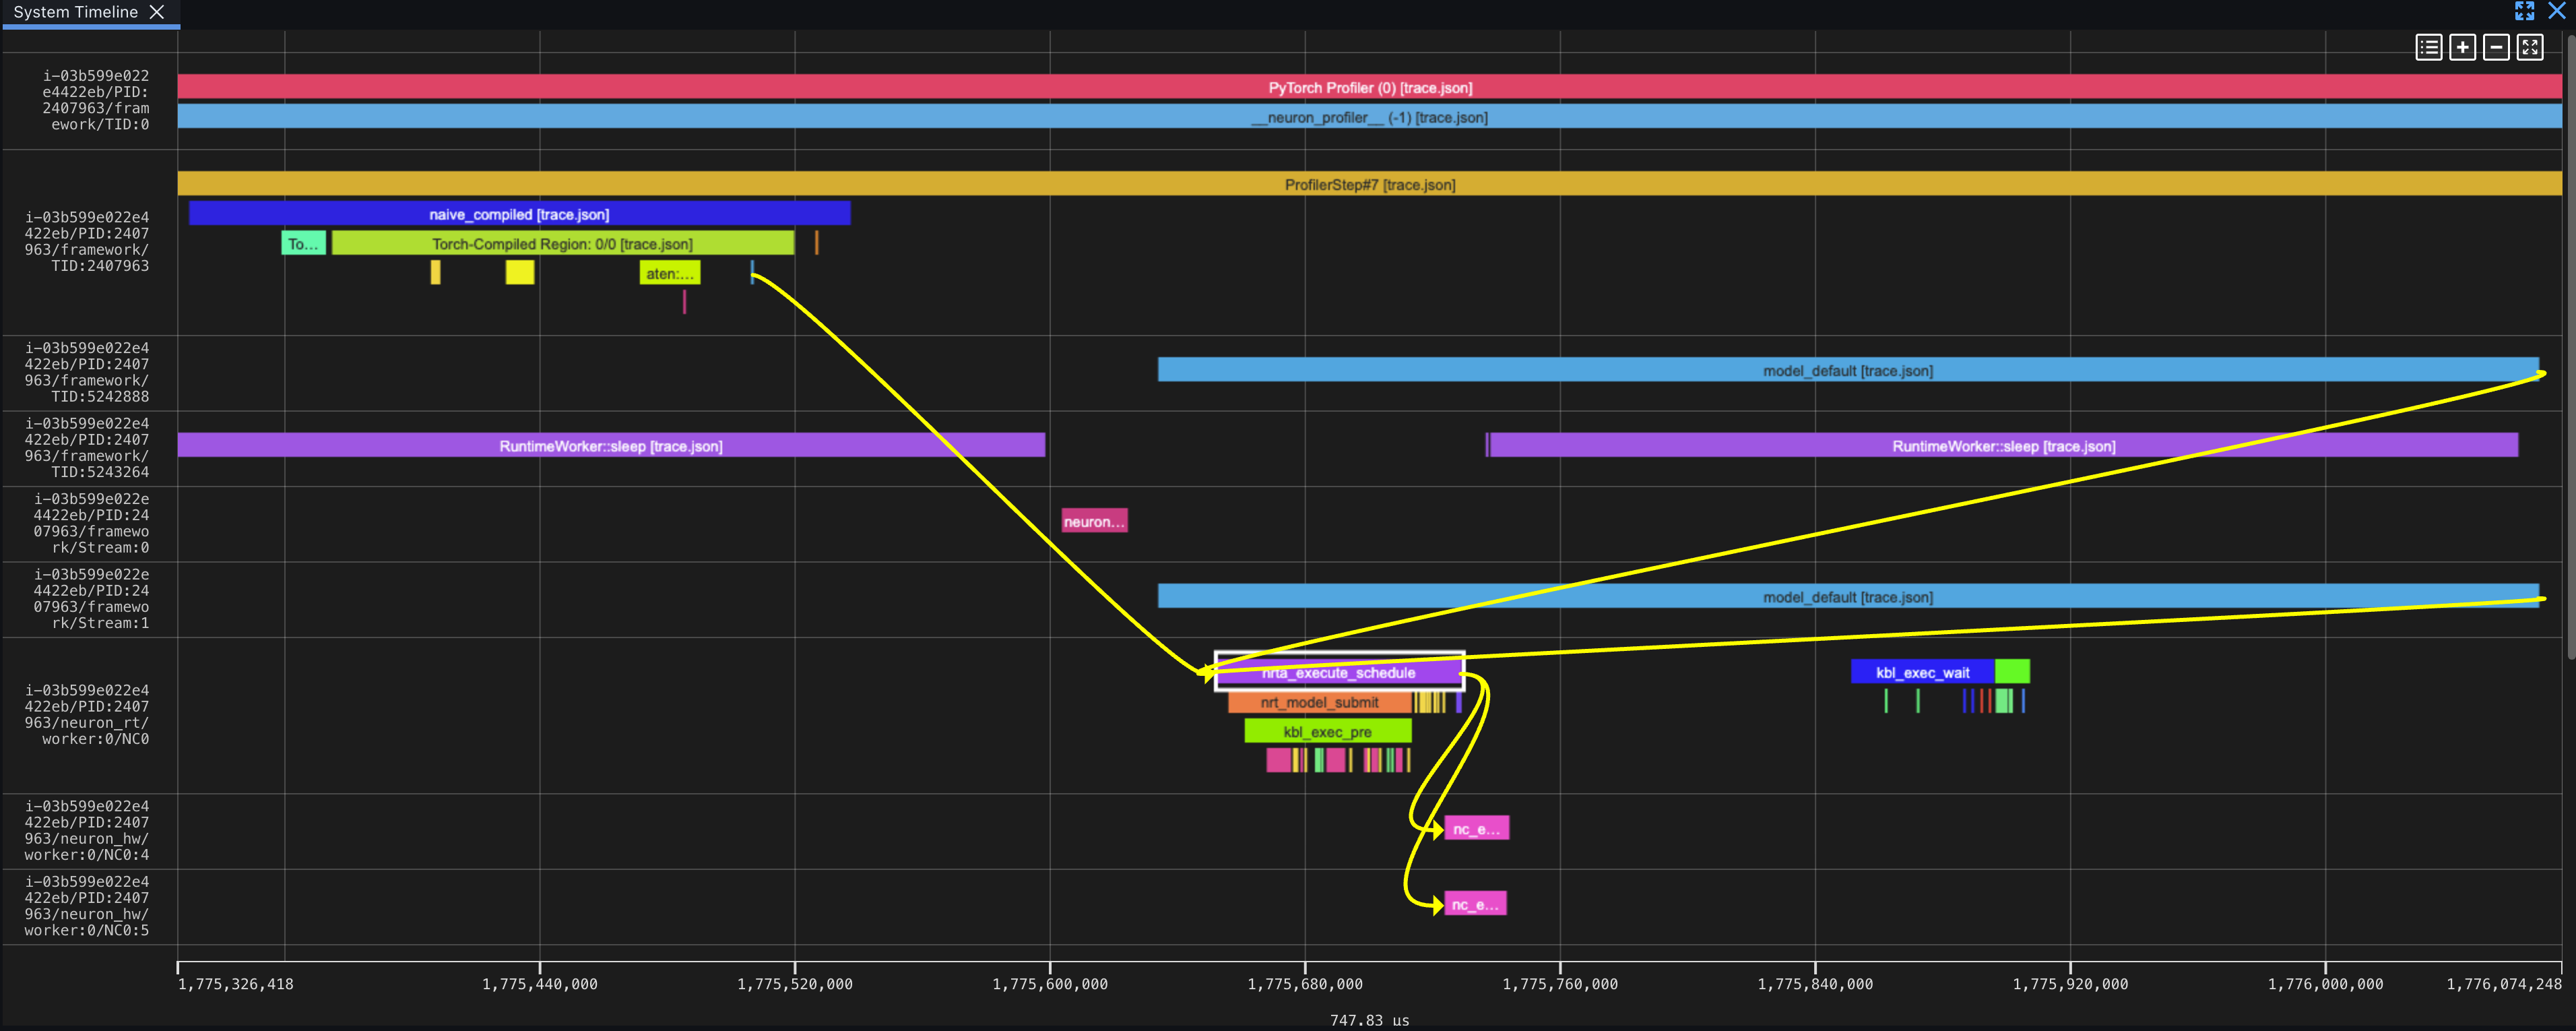
قدم اول در فرایند تحلیل، نصب و راهاندازی Neuron Explorer است؛ ابزاری که ردیابهای (trace) اجرا را ضبط و بهصورت بصری نمایش میدهد. پس از آمادهسازی ابزار، اولین هدف پروفایلکردن، لایه RMSNorm در مدل انتخابی است تا تفاوت بین روشهای مختلف پیادهسازی آن مشخص شود.
سه سناریوی پروفایلکردن و مقایسه مسیرها
آمازون سه سناریوی تحلیلی مجزا را مورد بررسی قرار داده تا مشخص شود هر رویکرد چگونه بر سرعت اجرا اثر میگذارد:
- پروفایل ۱: پیادهسازی ساده با اپراتورهای PyTorch بدون بهینهسازی (naive)
- پروفایل ۲: استفاده از torch.rms_norm بهعنوان اپراتور بومی
- پروفایل ۳: ترکیب اپراتورهای ساده PyTorch با torch.compile
در هر سناریو، ردیاب اجرا در Neuron Explorer خوانده میشود و مسیر پایینآوردن (lowering path) یا همان تبدیل کد PyTorch به دستورات قابل اجرا روی Trainium مقایسه میگردد. خلاصهی مقایسهای کنار-به-کنار نشان میدهد کدام رویکرد کمترین زمان صرفشده در گلوگاهها را دارد و کدام ساختار اجرایی برای بارهای کاری خاص بهتر است.
جمعبندی و نتیجهگیری
اگرچه این مطلب روی نسخه اول سری متمرکز است و در آینده قسمتهای دیگر نیز منتشر خواهد شد، اصول معرفیشده یعنی راهاندازی ابزار، ضبط ردیاب، خواندن خروجی و مقایسه سناریوها، پایهی هر تحلیل عملکرد پیشرفتهتری روی سختافزارهای مخصوص هوش مصنوعی خواهد بود.
پرسشهای پرتکرار
TorchNeuron چیست و چه نقشی روی AWS Trainium دارد؟
TorchNeuron بکاند بومی و متنباز PyTorch است که اجازه میدهد جریانهای کاری استاندارد پایتورچ — شامل اجرای eager، torch.compile و APIهای رایج — با حداقل تغییر روی تراشه AWS Trainium اجرا شوند. این پروژه با Neuron Kernel Interface نیز یکپارچه است تا اپراتورهای سفارشی برای سختافزار Trainium نوشته شود.
Neuron Explorer چگونه به تحلیل عملکرد کمک میکند؟
Neuron Explorer ابزاری است که ردیابهای (trace) اجرای مدل را ضبط کرده و بهصورت بصری نمایش میدهد. با استفاده از آن میتوان زمان صرفشده در هر مرحله از اجرا را خواند، مسیرهای پایینآوردن اپراتورها را مقایسه کرد و مشخص کرد گلوگاه اصلی افت کارایی در کجای استنتاج قرار دارد.